Option Pricing Models
Lattice Models
เปลี่ยนการเคลื่อนที่ของราคาให้เป็นต้นไม้เวลาไม่ต่อเนื่อง คำนวณย้อนหลัง และตรวจการลู่เข้าสู่คำตอบแบบต่อเนื่อง
แบบจำลองต้นไม้ทวินาม (Binomial Tree, 1979)
แบบจำลองต้นไม้ทวินาม (Binomial Tree) ถูกเสนอโดย ค็อกซ์ (John C. Cox), รอสส์ (Stephen A. Ross) และ รูบินสไตน์ (Mark Rubinstein) (Cox et al. 1979) แบบจำลองก่อนหน้านี้ล้วนออกแบบสำหรับออปชันแบบยุโรปเท่านั้น แต่ไม่เหมาะกับการคำนวณมูลค่าออปชันแบบอเมริกัน จึงมีการเสนอการคำนวณด้วยแผนภาพต้นไม้ (tree) ซึ่งเหมาะกับการพิจารณาการใช้สิทธิล่วงหน้า (Early Exercise Premium) อันเป็นเหตุผลหนึ่งที่มูลค่าออปชันแบบอเมริกันที่ยังไม่ใช้สิทธิมีค่าสูงกว่าหรือเท่ากับออปชันแบบยุโรปที่เทียบเท่ากัน อย่างไรก็ตามในกรณีทั่วไปต้นไม้ไม่มีรูปแบบปิด และแม้ต้นไม้แบบรวมกิ่ง (recombining) จะมีจำนวนโหนดรวมเพียง O(N2) (ต่างจากจำนวนเส้นทางทั้งหมดซึ่งโตแบบ 2N) การคำนวณด้วยมือก็ยังทำได้ยากเมื่อจำนวนขั้นมาก วิธีการนี้ตั้งสมมติฐานว่าในแต่ละช่วงเวลาสั้น ๆ ราคาสินทรัพย์เคลื่อนที่ได้เพียงสองทิศทาง คือขึ้นด้วยตัวคูณ u หรือลงด้วยตัวคูณ d ทำให้มูลค่าสินทรัพย์ขึ้นกับเส้นทาง (path) และเวลาเป็นแบบไม่ต่อเนื่อง (discrete time) ดังแสดงในรูปที่ 1
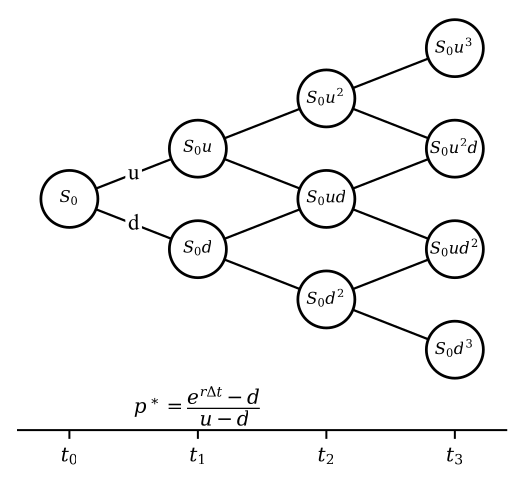 รูปที่ 1 · ต้นไม้ทวินามแบบรวมกิ่ง (recombining binomial tree) สามช่วงเวลา แสดงราคาสินทรัพย์ S0ujdi − j ณ โหนดต่าง ๆ พารามิเตอร์คงที่: u=eσΔt, d = 1/u, ความน่าจะเป็นเชิงกลาง-ความเสี่ยง p* = (erΔt − d)/(u − d). สังเกตว่าการเลื่อนขึ้นแล้วลงกลับมาที่โหนดเดียวกัน (recombining) ทำให้จำนวนโหนด ณ ขั้น i เท่ากับ i + 1 แทนที่จะเป็น 2i.
Proposition 11 (พารามิเตอร์และการเวียนซ้ำเชิงกลาง-ความเสี่ยง). แบ่งช่วงเวลา [0,T] เป็น N ขั้นย่อยเท่า ๆ กัน Δt=T/N กำหนด u=eσΔt,d=e−σΔt=u1,p∗=u−derΔt−d.(3.1) เมื่อ Δt เล็กพอจะได้ 0<p∗<1 และมูลค่าออปชันแบบยุโรป ณ โหนดใด ๆ สอดคล้องกับการเวียนซ้ำถอยหลัง (backward induction) Vi(j)=e−rΔt[p∗Vi+1(j+1)+(1−p∗)Vi+1(j)],(3.2) ในขณะที่ออปชันแบบอเมริกันแทนที่ด้วย Vi(j)=max{Λ(S0ujdi−j),e−rΔt[p∗Vi+1(j+1)+(1−p∗)Vi+1(j)]}.(3.3)
Proof. ค่า p∗ ถูกเลือกให้ราคาสินทรัพย์ที่คิดลดเป็นมาร์ทิงเกล กล่าวคือ EQ[Si+1∣Si]=erΔtSi ซึ่งให้ p∗u+(1−p∗)d=erΔt แก้หาได้ (3.1). ภายใต้มาตรวัดนี้มูลค่าออปชันคือค่าคาดหวังของมูลค่าขั้นถัดไปที่คิดลด นำไปสู่ (3.2). สำหรับออปชันอเมริกัน ณ แต่ละโหนดผู้ถือเลือกมูลค่าที่มากกว่าระหว่างการใช้สิทธิทันที Λ(S) กับการถือต่อ (continuation value) จึงได้ (3.3). เงื่อนไข erΔt∈(d,u) ที่ทำให้ p∗∈(0,1) เป็นเงื่อนไขไร้การเก็งกำไรพอดี. ◻
แบบจำลองต้นไม้ไตรนาม (Trinomial Tree, 1986)
แบบจำลองต้นไม้ไตรนาม (Trinomial Tree) ถูกเสนอโดย ฟีลิม บอยล์ (Phelim Boyle) (Boyle 1986) จากสมมติฐานเดิมของต้นไม้ทวินามที่ราคาสินทรัพย์มีเพียงสองทิศทาง บอยล์เสนอเพิ่มเส้นทางที่สามคือราคาคงที่ (middle) แม้จะเพิ่มความซับซ้อนในการคำนวณ แต่มีประโยชน์เพราะต้นไม้ไตรนามลู่เข้าสู่แบบจำลองแบล็ก-โชลส์อย่างราบเรียบกว่าและมีค่าคงตัวความคลาดเคลื่อนเล็กกว่าต้นไม้ทวินาม (อัตราการลู่เข้าเชิงอันดับเท่ากันคือ O(1/N) ดูหัวข้อการลู่เข้าของแบบจำลองเชิงต้นไม้สู่แบล็ก-โชลส์ด้านล่าง) ดังแสดงในรูปที่ 2 ทั้งนี้เราขอละการอธิบายแบบจำลองอื่น ๆ ในตระกูลต้นไม้ เช่น implied trees, non-combining trees และ N-nomial trees
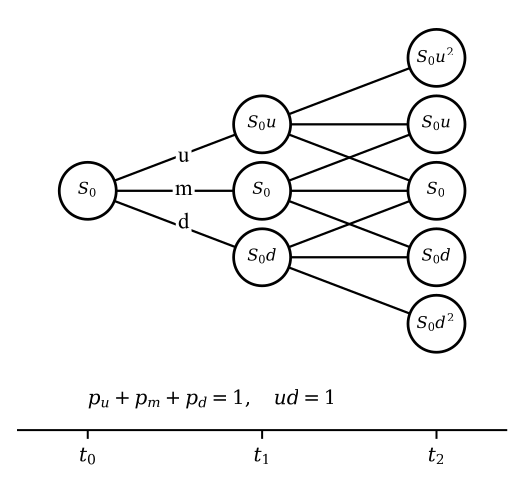 รูปที่ 2 · ต้นไม้ไตรนามแบบรวมกิ่งสองช่วงเวลา แต่ละโหนดแตกออกเป็นสามทิศทาง (ขึ้น u, คงที่ m, ลง d) โดยกำหนด ud = 1 เพื่อให้กิ่งรวมกันได้ ความน่าจะเป็น pu, pm, pd รวมกันเท่ากับ 1 ตาม (3.5). โครงสร้างสามทิศทางทำให้มีโหนดที่ราคาตรงกับราคาใช้สิทธิ ช่วยลดความคลาดเคลื่อนในการกำหนดราคา.
Proposition 12 (พารามิเตอร์ต้นไม้ไตรนามของบอยล์). กำหนด Δt=T/N และ u=eσ2Δt,d=u1,(3.4) ความน่าจะเป็นเชิงกลาง-ความเสี่ยงของสามทิศทางคือ pu=(eσΔt/2−e−σΔt/2erΔt/2−e−σΔt/2)2,pd=(eσΔt/2−e−σΔt/2eσΔt/2−erΔt/2)2,pm=1−pu−pd.(3.5) การเวียนซ้ำถอยหลังของมูลค่าออปชันคือ Vi(j)=e−rΔt[puVi+1(j+1)+pmVi+1(j)+pdVi+1(j−1)] (แทนด้วย max กับผลตอบแทนทันทีสำหรับออปชันอเมริกันเช่นเดียวกับ (3.3)).
Proof. สร้างหนึ่งขั้นไตรนามจากสองขั้นทวินามครึ่งช่วงเวลาอย่างชัดแจ้ง: กำหนดตัวคูณครึ่งขั้น a=eσΔt/2 และความน่าจะเป็นครึ่งขั้นแบบ CRR (เทียบ (3.1) ที่ช่วงเวลา Δt/2)
p~=a−a−1erΔt/2−a−1. การขึ้นสองครั้งติดกันให้ตัวคูณ a2=eσ2Δt=u ด้วยความน่าจะเป็น p~2 ซึ่งเท่ากับ pu ใน (3.5) พอดี การลงสองครั้งให้ d=1/u ด้วยความน่าจะเป็น (1−p~)2=pd และกรณีผสม (ขึ้น-ลง หรือ ลง-ขึ้น) กลับสู่โหนดกลางด้วยความน่าจะเป็น 2p~(1−p~)=1−pu−pd=pm. โครงสร้างนี้รับประกันเงื่อนไขมาร์ทิงเกล E[Si+1∣Si]=erΔtSi โดยอัตโนมัติ เพราะแต่ละครึ่งขั้นเป็นมาร์ทิงเกลที่คิดลดตามบทตั้ง 11. สำหรับโมเมนต์ของผลตอบแทนล็อก การคำนวณโดยตรง (แสดงในบทพิสูจน์ผลสืบเนื่อง 15) ให้ E[ln(Si+1/Si)]=(r−21σ2)Δt+O(Δt2) และ Var[ln(Si+1/Si)]=σ2Δt+O(Δt2) ตรงกับ GBM ถึงอันดับนำ. เงื่อนไข pu,pm,pd≥0 เป็นจริงเมื่อ Δt เล็กพอ (ต้องการ erΔt/2∈(a−1,a) ซึ่งเป็นเงื่อนไขไร้การเก็งกำไรต่อครึ่งขั้น). ◻
การลู่เข้าของแบบจำลองเชิงต้นไม้สู่แบล็ก-โชลส์
ในหัวข้อนี้เราพิสูจน์ว่าเมื่อจำนวนขั้น N→∞ ราคาออปชันจากต้นไม้ทวินามและไตรนามลู่เข้าสู่ราคาจากแบบจำลองแบล็ก-โชลส์ กุญแจสำคัญคือทฤษฎีบทลิมิตกลาง (Central Limit Theorem, CLT) ที่ทำให้ผลรวมของผลตอบแทนล็อกในแต่ละขั้นลู่เข้าสู่การแจกแจงปกติ อันเป็นการกระจายตัวของ ln(ST/S0) ในแบบจำลองแบล็ก-โชลส์
Assumption 13 (สมมติฐานที่จำเป็น). (i) พารามิเตอร์ r,σ คงที่; (ii) ขั้นย่อยเป็นอิสระและกระจายตัวเหมือนกัน (i.i.d.) ภายใต้ Q; (iii) ใช้พารามิเตอร์ CRR (3.1) สำหรับทวินาม และ (3.4)–(3.5) สำหรับไตรนาม; (iv) ฟังก์ชันผลตอบแทน Λ ต่อเนื่องและเติบโตไม่เกินเชิงเส้น เพื่อให้สลับลิมิตกับค่าคาดหวังได้ (uniform integrability).
Theorem 14 (การลู่เข้าของต้นไม้ทวินาม). ภายใต้สมมติฐาน 13 ราคาออปชันแบบยุโรปจากต้นไม้ทวินาม CN ลู่เข้าสู่ราคาแบล็ก-โชลส์ CBS เมื่อ N→∞ N→∞limCN=CBS.(3.6)
Proof. เขียนผลตอบแทนล็อกสะสม ln(ST/S0)=∑i=1NXi โดย Xi รับค่า lnu=σΔt ด้วยความน่าจะเป็น p∗ และ lnd=−σΔt ด้วยความน่าจะเป็น 1−p∗. กระจายอนุกรมของ p∗ ใน (3.1) รอบ Δt=0
p∗=eσΔt−e−σΔterΔt−e−σΔt=21+21(σr−21σ2)Δt+O(Δt3/2). จากนั้นคำนวณโมเมนต์ต่อขั้น E[Xi]Var[Xi]=(2p∗−1)σΔt=(r−21σ2)Δt+O(Δt2),=σ2Δt−E[Xi]2=σ2Δt+O(Δt2). รวม N=T/Δt ขั้นได้ค่าเฉลี่ยรวม μN=∑E[Xi]→(r−21σ2)T และความแปรปรวนรวม sN2=∑Var[Xi]→σ2T. เนื่องจาก Xi มีขอบเขต (∣Xi∣=σΔt→0) เงื่อนไขลินเดอเบิร์ก (Lindeberg condition) เป็นจริง กล่าวคือสำหรับทุก ϵ>0 sN21i=1∑NE[(Xi−EXi)21{∣Xi−EXi∣>ϵsN}]→0, เพราะเมื่อ N ใหญ่พอ ∣Xi−EXi∣≤2σΔt<ϵsN ทำให้ตัวชี้บ่ง (indicator) เป็นศูนย์ทั้งหมด. โดยทฤษฎีบทลินเดอเบิร์ก-เฟลเลอร์ (Lindeberg-Feller CLT) i=1∑NXidN((r−21σ2)T, σ2T), ซึ่งตรงกับการแจกแจงของ ln(ST/S0) ในแบบจำลองแบล็ก-โชลส์พอดี. โดยทฤษฎีบทการส่งต่อเนื่อง (continuous mapping theorem) และความต่อเนื่องของ Λ จะได้ Λ(ST(N)) ลู่เข้าในการแจกแจงสู่ Λ(ST) เหลือเพียงตรวจสอบความอินทิเกรตได้อย่างเอกรูป (uniform integrability) ซึ่งพิสูจน์ได้จริงจากขอบเขตโมเมนต์ที่สอง: เนื่องจาก ud=1 E[(ST(N))2]=S02[p∗u2+(1−p∗)d2]N=S02[erΔt(u+d)−1]N=S02[1+(2r+σ2)Δt+O(Δt2)]N, ดังนั้น supNE[(ST(N))2]≤S02e(2r+σ2)T+O(Δt)<∞. ขอบเขตโมเมนต์ที่สองอย่างสม่ำเสมอร่วมกับการเติบโตไม่เกินเชิงเส้นของ Λ ตามสมมติฐาน 13(iv) ให้ uniform integrability ของ {Λ(ST(N))}N การลู่เข้าในการแจกแจงจึงส่งผลให้ค่าคาดหวังของผลตอบแทนที่คิดลดลู่เข้า และได้ (3.6). ◻
Corollary 15 (การลู่เข้าของต้นไม้ไตรนาม). ภายใต้สมมติฐาน 13 ราคาจากต้นไม้ไตรนามลู่เข้าสู่ CBS เช่นกัน โดยผลตอบแทนต่อขั้น Xi รับสามค่า {σ2Δt,0,−σ2Δt} ด้วยความน่าจะเป็น {pu,pm,pd} ซึ่งจับคู่โมเมนต์ที่หนึ่งและที่สองให้ตรงกับ GBM ทำให้เงื่อนไขลินเดอเบิร์กเป็นจริงด้วยเหตุผลเดียวกัน.
Proof. จากนิยาม (3.5) เขียน a=eσΔt/2 ผลต่างของกำลังสองให้
pu−pd=(a−a−1)2(erΔt/2−a−1)2−(a−erΔt/2)2=a−a−12erΔt/2−a−a−1=(2σr−21σ2)2Δt+O(Δt3/2), โดยกระจายอนุกรม 2erΔt/2−a−a−1=(r−21σ2)Δt+O(Δt2) และ a−a−1=σ2Δt+O(Δt3/2). ดังนั้น E[Xi]=(pu−pd)σ2Δt=(r−21σ2)Δt+O(Δt2) และ Var[Xi]=(pu+pd)⋅2σ2Δt−E[Xi]2=σ2Δt+O(Δt2) (ใช้ pu+pd=21+O(Δt)) ที่เหลือเหมือนบทพิสูจน์ทฤษฎีบท 14. ◻
Remark 16. ทฤษฎีบท 14 และผลสืบเนื่อง 15 ครอบคลุมเฉพาะออปชันแบบยุโรป การลู่เข้าของราคาออปชันแบบอเมริกันจากแบบจำลองเชิงต้นไม้สู่มูลค่าการหยุดเหมาะสมในเวลาต่อเนื่อง (1.3) เป็นผลลัพธ์ที่ลึกกว่าและต้องอาศัยเทคนิคเพิ่มเติม ดูบทพิสูจน์ของอามินและคานนา (Amin and Khanna 1994).
อัตราการลู่เข้า (เชิงคณิตศาสตร์และเชิงคำนวณ)
เชิงคณิตศาสตร์ ทั้งสองแบบจำลองมีอัตราการลู่เข้าอันดับหนึ่ง ∣CN−CBS∣=O(1/N) แต่ต้นไม้ทวินามมีองค์ประกอบ แกว่ง (oscillatory) แบบฟันเลื่อยตามภาวะคู่/คี่ของ N เนื่องจากตำแหน่งของราคาใช้สิทธิ K เทียบกับโหนดปลายทางสลับไปมา ในทางตรงข้ามต้นไม้ไตรนามมีโหนดกลางที่จัดวางให้ตรงกับ K ได้ดีกว่า จึงลู่เข้าอย่างราบเรียบและมีค่าคงตัวคลาดเคลื่อนเล็กกว่า รูปที่ 3 ยืนยันข้อสังเกตนี้เชิงคำนวณ โดยแสดงความคลาดเคลื่อนสัมบูรณ์เทียบกับจำนวนขั้นในมาตราส่วนล็อก
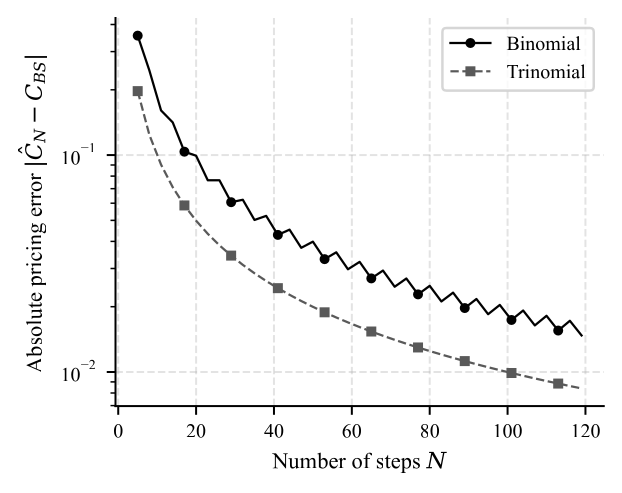 รูปที่ 3 · ความคลาดเคลื่อนสัมบูรณ์ |ĈN − CBS| ของการกำหนดราคาออปชันซื้อแบบยุโรป (พารามิเตอร์คงที่: S0 = K = 100, r = 0.05, σ = 0.20, T = 1) เทียบกับจำนวนขั้น N ในมาตราส่วนกึ่งล็อก สังเกตการแกว่งแบบฟันเลื่อยของต้นไม้ทวินาม (เส้นทึบ) เทียบกับการลู่เข้าที่ราบเรียบและเร็วกว่าของต้นไม้ไตรนาม (เส้นประ) ซึ่งสอดคล้องกับการวิเคราะห์เชิงทฤษฎี.
ทดลองต้นไม้ Binomial
เปิด JavaScript เพื่อปรับค่าห้องทดลองนี้ สมการและตัวอย่างในบทอ่านได้ตามปกติ
จำนวนขั้นและการลู่เข้า
เปิด JavaScript เพื่อปรับค่าห้องทดลองนี้ สมการและตัวอย่างในบทอ่านได้ตามปกติ