พฤติกรรมแบบสุ่มของสินทรัพย์
The Random Behavior of Assets
“ปัจจัยที่กำหนดการเคลื่อนไหวของตลาดหุ้นมีมากมายนับไม่ถ้วน”
“Les influences qui déterminent les mouvements de la Bourse sont innombrables…”
— Louis Bachelier · Théorie de la spéculation (1900), น. 21
“มีคนเพียง สองประเภทที่ บอกว่าเขาสามารถทำนาย ทิศทางราคาได้ ........... คือคนเสียสติ และ คนโกหก”
เรากำลังมาถึงสิ่งที่าำคัญที่สุดของ Quant นั้นคือการเข้าใจตลาดกหารเงินว่ามันสุ่มมมมมมม ผมอยากเริ่มต้นที่คำถาม อะไรบ้างที่ส่งผลต่อราคาหุ้น .
.
.
.
.
.
.
ข่าวที่เพิ่งออก ผลประกอบการที่ประกาศไปแล้ว สิ่งที่คนคาดว่าจะเกิดในอนาคต รวมถึงการซื้อขายของคนอื่น ทั้งหมดเข้ามารวมอยู่ในราคา บางเรื่องดูเหมือนไม่เกี่ยวกับหุ้นตัวนั้นเลย แต่สุดท้ายก็ส่งผลถึงกันได้
ที่สำคัญ ตลาดยังตอบสนองต่อการเคลื่อนไหวของตัวเองด้วย ราคาที่เปลี่ยนไปทำให้คนเปลี่ยนใจ แล้วการตัดสินใจรอบใหม่ก็กลับมาเปลี่ยนราคาอีกที ในทุก คำสั่งที่ถูกซื้อขายมีทั้งคนซื้อและคนขาย เราเห็นราคาเดียวกันได้ แต่มีความคาดหวัง เหตุผล และข้อจำกัดต่างกัน การจะรวบรวมทุกปัจจัยเพื่อบอกล่วงหน้าว่าราคาต้องไปอยู่ตรงไหนจึงเป็นโจทย์ที่เป็นไปไม่ได้
และนี้คือแนวคิดหลักของ Louis Bachelier ในงานปริญาเอกที่ถูกลืมอย่าง Théorie de la spéculation เมื่อปี 1900 จากแนวคิดนี้ เราถามต่อได้ว่า ถ้าเราไม่รู้ว่าราคาจะเคลื่อนไปทางไหนแน่ ๆ เราจะอธิบายได้ไหมว่า การเคลื่อนไหวแต่ละแบบมีโอกาสเกิดมากน้อยแค่ไหน? อ่านงานต้นฉบับของ Bachelier แล้วถ้าราคาไม่แน่นอนเราจะทำแบบจำลองบนมันได้อย่างไร โชคดีของพวกเราที่ บาเซลิเย่ตอบคำถามพวดนั้นหมดแล้ว
การใช้คณิตศาสตร์ศึกษาความเป็นไปได้ของราคา คือหนึ่งในรากฐานสำคัญของการเงินเชิงปริมาณ หรือ Quant งานของ Bachelier เป็นหมุดหมายแรก ๆ ของการนำความน่าจะเป็นมาศึกษาราคา แนวคิดนี้ยังต้องอาศัยสมมติฐานและการตรวจสอบกับข้อมูล เราไม่สามารถทำนายราคาแต่เราสร้างโมเดลได้
สำหรับบทนี้ ผมจะพาทุกคนมาเข้าใจหลักการสำคัญก่อนมากกว่า Bug World หรือเครื่องมือสำเร็จรูป แล้วค่อยต่อยอดไปสู่แบบจำลองราคาที่มีทั้งการเปลี่ยนแปลงเฉลี่ยและส่วนสุ่ม
พื้นฐาน Option และ payoff · Jensen’s inequality · ผลตอบแทน · ค่าเฉลี่ยและความผันผวน · Wiener process · แบบจำลองราคาสินทรัพย์ในเวลาต่อเนื่อง
ศัพท์ที่ขีดเส้นใต้แบบจุดกดอ่านความหมายได้ใน อภิธานศัพท์
บทนำ
ในบทนี้จะสร้างแบบจำลองแรกของการเงิน เพื่อให้เข้าใจพฤติกรรมการสุ่มนี้ กล่าวคือ ผลที่เกิดขึ้นในแต่ละครั้งไม่แน่นอน แต่เรายังสามารถอธิบายกฎความน่าจะเป็นของมัน และศึกษาผลสะสมเมื่อทำซ้ำหลายครั้งได้
จากจุดนี้เราจะเข้าสู่เรื่อง stochastic calculus หรือแคลคูลัสของกระบวนการสุ่ม (เราไม่ได้จะพาไปสมการยากๆ stochastic = สุ่ม , แคลคูลัส คือการศึกษาการเปลี่ยนแปลงและการรวมกัน ) และ Wiener process แม้เบื้องหลังแนวคิดเหล่านี้จะมีทฤษฎีอยู่มาก แต่เป้าหมายของบทคือสร้างความเข้าใจต่อแบบจำลองก่อน รายละเอียดทางคณิตศาสตร์จะตามมาในบทถัดไป (ถ้าผมยังเขียนต่อนะ )
แนวทางการวิเคราะห์ที่นิยมใช้
ก่อนจะไปต่อ ผมอยากชวนดูว่าเวลาคนพูดว่า “วิเคราะห์หุ้น” เขากำลังวิเคราะห์อะไรกันอยู่ เรามักได้ยินอยู่สามคำคือ Fundamental, Technical และ Quant แต่ละแบบเริ่มจากคนละคำถาม และในงานจริงก็ใช้ร่วมกันได้
การวิเคราะห์ปัจจัยพื้นฐาน — Fundamental analysis
ถ้าเรามองหุ้นเป็นส่วนหนึ่งของธุรกิจ คำถามแรกก็คือ ธุรกิจนี้ควรมีมูลค่าเท่าไร? เราจึงต้องดูว่าบริษัทหาเงินจากอะไร รายได้โตได้อีกไหม ต้นทุนกับหนี้เป็นอย่างไร และอะไรทำให้ลูกค้ายังเลือกซื้อของจากบริษัทนี้
ลองสมมติว่าเราประเมินหุ้นตัวหนึ่งไว้ที่ 80 บาท แต่ตลาดซื้อขายกันอยู่ที่ 60 บาท ดูเหมือนมีส่วนต่างให้เราแล้วใช่ไหม? ปัญหาคือ 80 บาทนั้นยังเป็นผลจากสมมติฐานของเรา ถ้ายอดขายไม่โตตามที่คิด หรือบริษัทต้องลงทุนมากกว่าที่คาด มูลค่าที่คำนวณได้ก็เปลี่ยน และอย่างที่บอกว่า ปัจจัยกำหนดราคาหุ้นมีมากมายนับอนัน
อีกเรื่องคือ ต่อให้เราประเมินถูก ราคาก็อาจอยู่ที่ 60 บาทต่อไปอีกนาน การตอบว่า “ควรมีมูลค่าเท่าไร” กับ “เมื่อไรตลาดจะให้ราคานั้น” จึงเป็นคนละโจทย์ เราต้องคิดเรื่องเวลาที่รอได้และความเสี่ยงระหว่างทางด้วย
การวิเคราะห์ทางเทคนิค — Technical analysis
แนวทางนี้เริ่มจากสิ่งที่เกิดขึ้นในตลาดแล้ว เช่น ราคา ปริมาณซื้อขาย และรูปแบบการเคลื่อนไหว เราอาจดูว่าราคากำลังเป็นแนวโน้ม เคลื่อนไหวในกรอบ หรือเปลี่ยนพฤติกรรมไปจากช่วงก่อนหน้า
แต่ปัญหาหลักคือ เทคนิคอลทั้งหมด มักจะไม่มีกฏที่แน่นอน แม้กระทั้งนักวิเคราะที่เก่งที่สุด สองคนอาจจะมองต่างกัน
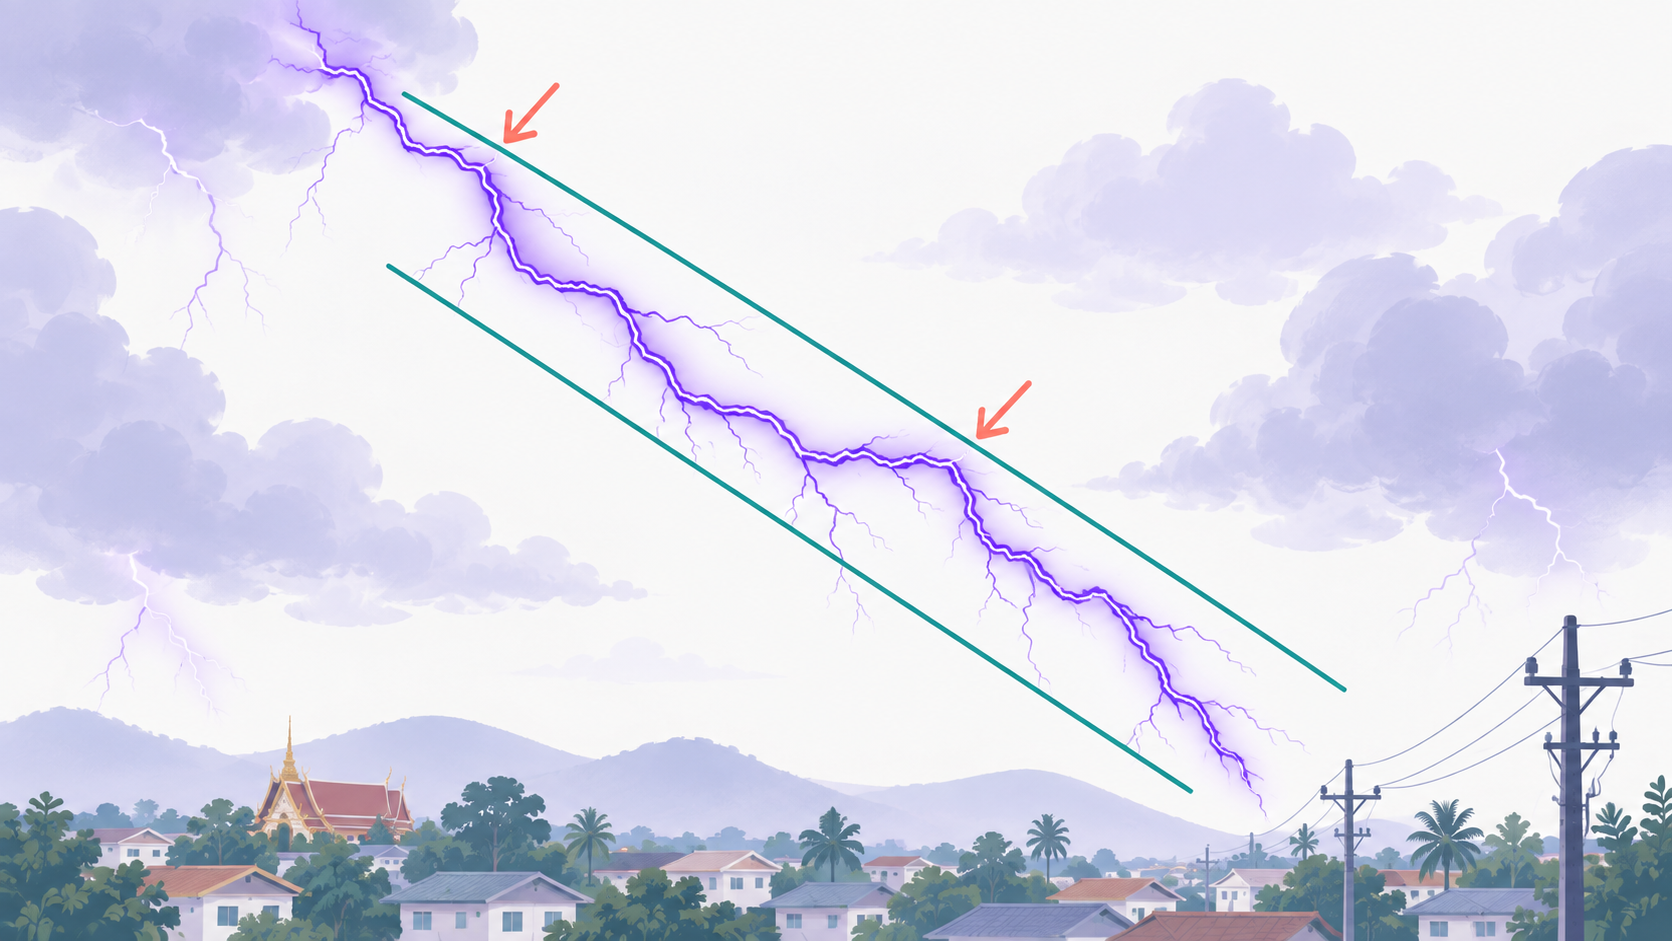
“แนวรับแข็งมาก… เสาไฟยังอยู่” — มุกขำ ๆ ของการเห็นรูปแบบในทุกอย่าง ลากเส้นให้เข้ากับสิ่งที่เกิดขึ้นแล้วอาจทำได้ง่าย แต่จะใช้คาดการณ์สิ่งที่ยังไม่เกิดได้จริงไหม ต้องทดสอบกันอีกเรื่อง
การวิเคราะห์เชิงปริมาณ — Quantitative analysis
สำหรับ Quant ถ้าให้ผมนิยามความหมาย คงหมายถึงศาตร์ที่ศึกษา พลวัตร์(สุ่ม)ของตราสารทางการเงิน เราพยายามทำคำถามให้ชัดพอที่จะวัดและตรวจสอบได้ ใช้ข้อมูล คณิตศาสตร์ และสถิติมาสร้างแบบจำลอง แล้วดูว่าคำตอบเปลี่ยนอย่างไรเมื่อสมมติฐานเปลี่ยน
ตัวอย่างเช่น ถ้าพอร์ตหนึ่งมีโอกาสขาดทุน เราจะประมาณขนาดของการขาดทุนนั้นอย่างไร? ถ้าสินทรัพย์หลายตัวตกพร้อมกัน ความเสี่ยงรวมจะเพิ่มแค่ไหน? หรือถ้าสัญญาจะจ่ายเงินตามราคาหุ้นในอนาคต วันนี้เราควรประเมินมูลค่าของสิทธินั้นอย่างไร?
ในบทนี้เราจะเริ่มจาก แบบจำลองความสุ่มของราคา และเราจะเข้าใจ หลักการของ Quant ผ่านตราสารทางการเงินที่เรียกว่า Option
เข้าใจ Quant ผ่าน Option
Option คือสัญญาที่ให้ผู้ถือมี สิทธิ แต่ไม่มีข้อผูกมัดว่าต้องใช้สิทธิ ในการซื้อหรือขายสินทรัพย์ตามราคาและเงื่อนไขที่ตกลงกัน สิทธิซื้อเรียกว่า Call option ส่วนสิทธิขายเรียกว่า Put option ผู้ซื้อจ่ายเงินเพื่อให้ได้สิทธินี้ เงินนั้นเรียกว่า premium หรือราคาออปชัน
ลองเริ่มจาก Call ก่อน สมมติว่าเรามีสิทธิซื้อหุ้นหนึ่งหน่วยในราคา 120 บาท เมื่อครบหนึ่งเดือน โดยจ่ายค่าซื้อสิทธินี้ไป 8 บาท ราคา 120 บาทเรียกว่า ราคาใช้สิทธิ (strike price) และวันที่ครบหนึ่งเดือนคือ วันหมดอายุ (expiration) ตัวอย่างนี้กำหนดให้ใช้สิทธิได้ในวันหมดอายุเท่านั้น หรือที่เรียกว่า European option
ถ้าวันนั้นหุ้นมีราคา 160 บาท สิทธิซื้อที่ 120 บาทก็มีมูลค่า 40 บาท แต่ถ้าหุ้นเหลือ 90 บาท เราก็ไม่จำเป็นต้องใช้สิทธิซื้อแพงกว่าตลาด สิทธินั้นจึงมี payoff เป็นศูนย์ ส่วนผู้ขาย Option มีหน้าที่ทำตามสัญญาเมื่อมีการใช้สิทธิ
| ราคาหุ้นวันหมดอายุ | Payoff ของ Call ต่อหนึ่งหน่วย | กำไร/ขาดทุนหลังหัก premium 8 บาท |
|---|---|---|
| 160 บาท | 40 บาท | 32 บาท |
| 120 บาท | 0 บาท | −8 บาท |
| 90 บาท | 0 บาท | −8 บาท |
ตัวอย่างนี้ยังไม่รวมค่าธรรมเนียมและมูลค่าของเงินตามเวลา payoff ไม่ใช่กำไรสุทธิ และไม่ใช่ราคา Option ที่เราจ่ายวันนี้ แม้เราเลือกไม่ใช้สิทธิ เงิน 8 บาทที่จ่ายไปก็ไม่ได้คืน
ถ้าเขียนเป็นสูตร ให้ S_T เป็นราคาหุ้นวันหมดอายุ และให้ K เป็นราคาใช้สิทธิ จะได้ payoff ของ Call ต่อหนึ่งหน่วยเท่ากับ max(S_T − K, 0) กล่าวคือ รับส่วนต่างเมื่อราคาหุ้นสูงกว่า K และเป็นศูนย์เมื่อราคาไม่สูงกว่า K
ตรงนี้แหละที่เชื่อมไปสู่การกำหนดราคา Option: ตอนนี้เรารู้แล้วว่าจะคำนวณ payoff อย่างไรเมื่อถึงวันหมดอายุ แต่ วันนี้ควรจ่ายเท่าไรเพื่อซื้อสิทธินั้น? จำนวน 8 บาทข้างต้นเป็นเพียงราคาที่สมมติขึ้น ยังไม่ได้พิสูจน์ว่าเป็นราคาที่เหมาะสม เราต้องพิจารณาผลลัพธ์ที่อาจเกิดขึ้นและวิธีประเมินมูลค่าของมันก่อน
เหตุใดจึงต้องจำลองความสุ่ม: Jensen’s inequality
เมื่อรู้จัก payoff แล้ว ลองกลับมาตั้งคำถามเรื่องราคา: ถ้าเราประมาณราคาหุ้นเฉลี่ยในอนาคตได้ ทำไมไม่เอาราคาเฉลี่ยนั้นไปแทนในสูตร Call แล้วคิดลดกลับมาเป็นราคาวันนี้เลย? ลองดูตัวอย่างต่อไปนี้ แล้วเราจะเห็นว่าข้อมูลอะไรหายไปเมื่อเฉลี่ยเร็วเกินไป
ให้ราคาหุ้นวันนี้เท่ากับ 100 ดอลลาร์ อีกหนึ่งปีมีสองกรณี: ขึ้นเป็น 150 ดอลลาร์ ด้วยโอกาส 0.6 หรือลงเป็น 50 ดอลลาร์ ด้วยโอกาส 0.4 ตัวเลขนี้เป็นความน่าจะเป็นในโลกจริงที่เราสมมติขึ้น เรียกว่า p ส่วน Call มีราคาใช้สิทธิ 100 ดอลลาร์และหมดอายุในอีกหนึ่งปี
ถ้าเฉลี่ยราคาก่อน เราจะได้ 0.6 × 150 + 0.4 × 50 = 110 ดอลลาร์ เมื่อนำไปแทนในสูตร Call จะได้ max(110 − 100, 0) = 10 ดอลลาร์
แต่ถ้าคำนวณ payoff แยกทีละกิ่ง ขาขึ้นจ่าย 50 และขาลงจ่าย 0 จากนั้นค่อยถ่วงน้ำหนัก จะได้ 0.6 × 50 + 0.4 × 0 = 30 ดอลลาร์ เฉลี่ยก่อนกับคำนวณ payoff ก่อนจึงให้คำตอบคนละค่า
ลำดับของการคำนวณจึงสำคัญ payoff ของราคาคาดหมาย ไม่จำเป็นต้องเท่ากับค่าคาดหมายของ payoff และ 30 ดอลลาร์นี้ยังเป็นเพียง payoff คาดหมายภายใต้ p ไม่ใช่ราคา Call วันนี้
ในทางคณิตศาสตร์ ตัวอย่างนี้เป็นกรณีหนึ่งของ Jensen’s inequality ถ้า f เป็นฟังก์ชันนูนของตัวแปรสุ่ม S และค่าคาดหมายที่เกี่ยวข้องมีอยู่ จะได้ว่า
Payoff ของ call คือ f(S) = max(S − K, 0) ซึ่งเป็นฟังก์ชันนูน ความนูนในที่นี้ไม่จำเป็นต้องเป็นเส้นโค้งเรียบ เส้นตรงสองช่วงที่หักมุมตรงราคาใช้สิทธิก็เป็นฟังก์ชันนูนได้
การแจกแจงและความแปรปรวนเข้ามาเกี่ยวข้องกันอย่างไร
ลองขยายความสัมพันธ์นี้ด้วย Taylor expansion รอบค่าเฉลี่ย โดยกำหนดให้
ถ้าฟังก์ชันทำให้เราสเกลได้ เราเขียนโดยประมาณว่า
เทอมอันดับหนึ่งหายไปเพราะ ε มีค่าเฉลี่ยศูนย์ ส่วนต่างที่เหลือจึงเชื่อมโยงกับสองสิ่ง ได้แก่ ความนูนของฟังก์ชัน ซึ่งสะท้อนผ่านอนุพันธ์อันดับสอง และ ความแปรปรวนของสินทรัพย์อ้างอิง ซึ่งวัดขนาดความไม่แน่นอน
นี่คือเหตุผลที่ความเข้าใจจากสัญญาเชิงเส้นอย่าง forward หรือ futures อาจนำมาใช้กับออปชันโดยตรงไม่ได้ สำหรับ payoff ที่ไม่เป็นเส้นตรง การรู้ค่าเฉลี่ยของสินทรัพย์อ้างอิงยังไม่พอ เราต้องรู้ลักษณะการกระจายของมันด้วย
Taylor expansion เป็นการประมาณสำหรับฟังก์ชันที่เรียบพอ ไม่ควรนำอนุพันธ์อันดับสองธรรมดาไปแทนตรงมุมของ payoff ของ Call ที่ราคาใช้สิทธิโดยตรง
ไม่ต้องทายถูกทุกครั้ง แล้วเราหาราคา Option ได้อย่างไร
เมื่อกี้เราเห็นแล้วว่าเฉลี่ย payoff กับคำนวณ payoff จากราคาเฉลี่ยให้คำตอบต่างกัน แต่ยังเหลือคำถามใหญ่: แล้วราคา Option วันนี้ควรเป็นเท่าไร? คราวนี้ลดโจทย์ให้เหลือแค่หนึ่งวัน จะได้เห็นเหตุผลทีละขั้น
หุ้นวันนี้ราคา 100 ดอลลาร์ พรุ่งนี้ขึ้นเป็น 101 ด้วยโอกาส 0.6 หรือลงเป็น 99 ด้วยโอกาส 0.4 เรามี European Call ที่ K = 100 และหมดอายุพรุ่งนี้ ให้ราคาที่ยังไม่รู้วันนี้เป็น V สมมติดอกเบี้ย 0% ไม่มีเงินปันผลและค่าธรรมเนียม ซื้อขายหุ้นเป็นเศษส่วน กู้ยืม และขายชอร์ตหุ้นหรือ Option ได้ตามต้องการ
ความน่าจะเป็นไม่ส่งผลต่อราคา
ถ้าหุ้นเป็น 101 เราใช้สิทธิได้ส่วนต่าง 1 ถ้าหุ้นเป็น 99 เราไม่ใช้สิทธิ จึงได้ 0 ดูเผิน ๆ เราอาจตอบว่า Call ควรมีราคา 0.6 × 1 + 0.4 × 0 = 0.6 ดอลลาร์ แต่ตัวเลขนี้เป็น payoff คาดหมายตาม p ที่สมมติไว้
ลองพักเรื่องทิศทางราคาไว้ก่อน แล้วถามใหม่ว่า เราจัดพอร์ตให้ผลลัพธ์เหมือนกันทั้งขาขึ้นและขาลงได้ไหม?(Replicate)
ซื้อ Call หนึ่งหน่วย แล้วขายชอร์ตหุ้นครึ่งหุ้น
การขายชอร์ตคือยืมหุ้นมาขายก่อน และมีภาระต้องซื้อกลับไปคืนภายหลัง ไม่ได้แปลว่ามีหุ้นติดลบโดยไม่มีภาระอะไร ถ้าเราถือ Call หนึ่งหน่วยกับสถานะชอร์ตหุ้นครึ่งหุ้น มูลค่าสุทธิของพอร์ตวันนี้คือ V − ½ × 100 = V − 50
พรุ่งนี้ลองคิดแยกทีละกิ่ง:
- หุ้นขึ้นเป็น 101: Call มีค่า 1 แต่ต้องซื้อหุ้นครึ่งหุ้นคืนในราคา 50.5 มูลค่าสุทธิจึงเป็น 1 − 50.5 = −49.5
- หุ้นลงเป็น 99: Call มีค่า 0 และซื้อหุ้นครึ่งหุ้นคืนในราคา 49.5 มูลค่าสุทธิจึงเป็น 0 − 49.5 = −49.5
ราคาหุ้นยังไม่แน่นอน แต่ผลลัพธ์สุทธิของพอร์ตนี้แน่นอนแล้ว เราเรียกการจัดพอร์ตเพื่อหักล้างความเสี่ยงแบบนี้ว่า Hedging เลขติดลบ −49.5 หมายถึงภาระสุทธิที่ต้องจ่ายเมื่อปิดสถานะพรุ่งนี้ ไม่ใช่กำไร และไม่ได้แปลว่าเราเพิ่งขาดทุน 49.5 เพราะต้องนับเงินรับจากการขายชอร์ตวันนี้ด้วย
และถ้าคุณซืื้อ ที่ 0.6 Quant จึงทำกำไรจากคุณ
ภาระที่ต้องจ่าย 49.5 พรุ่งนี้ เมื่อดอกเบี้ยเป็นศูนย์ มีมูลค่าเป็นภาระ 49.5 วันนี้เช่นกัน ดังนั้น
จะดูเป็นกระแสเงินสดก็ได้: ขายชอร์ตครึ่งหุ้นรับ 50 จ่ายซื้อ Call 0.5 เหลือ 49.5 เก็บเงินนี้ไว้ พรุ่งนี้เงินที่เก็บไว้พอดีกับภาระสุทธิ 49.5 ไม่ว่าหุ้นจะขึ้นหรือลง
แล้วทำไมราคาตลาดต้องยอมตาม 0.5? ภายใต้สมมติฐานนี้ ถ้า Call ขายที่ 0.6 เราขาย Call ซื้อหุ้นครึ่งหุ้น และกู้ 49.5 จะรับเงินสุทธิวันนี้ 0.6 − 50 + 49.5 = 0.1 ส่วนพรุ่งนี้หุ้นลบ payoff ที่ต้องจ่ายและหนี้รวมกันได้ศูนย์ทั้งสองกรณี ถ้า Call ขายที่ 0.4 ก็กลับด้าน: ซื้อ Call ชอร์ตครึ่งหุ้น และฝาก 49.5 รับสุทธิวันนี้ −0.4 + 50 − 49.5 = 0.1 และปิดภาระพรุ่งนี้ได้ครบ นี่คือเหตุผลแบบ no arbitrage ที่บังคับให้ราคาเป็น 0.5 ในแบบจำลอง
แล้วรู้ได้อย่างไรว่าต้องชอร์ตครึ่งหุ้น
เราเลือกจำนวนหุ้น h ให้ผลลัพธ์สองกิ่งเท่ากัน: 1 − 101h = 0 − 99h จึงได้ h = (1 − 0) ÷ (101 − 99) = 0.5 หรือเขียนทั่วไปว่า hedge ratio เท่ากับ ส่วนต่าง payoff ÷ ส่วนต่างราคาหุ้น
ครึ่งหุ้นจึงเป็นสัดส่วนที่คำนวณได้ ไม่ใช่การเดา และไม่ใช่ค่าคงที่สำหรับทุก Option เราขยายขนาดเป็น Call สองหน่วยกับหุ้นหนึ่งหุ้นได้ แต่ต้องคำนึงถึงจำนวนหุ้นอ้างอิงต่อสัญญาจริงด้วย
บางกลยุทธ์ดูแปลกถ้ามองทีละรายการ ทำไมซื้อ Call แล้วกลับขายชอร์ตหุ้น? เพราะเราไม่ได้ถามแค่ว่า “ราคาจะขึ้นหรือลง” เราถามว่า จะประกอบสถานะอย่างไรให้ได้ผลลัพธ์หรือความเสี่ยงที่ต้องการ เหตุผลอยู่ที่ทั้งพอร์ต และต้องตรวจสอบออกมาเป็นตัวเลขได้
p หายไปไหน แล้ว risk-neutral เข้ามาตอนไหน
สังเกตว่าตั้งแต่ทำให้สองกิ่งเท่ากันจนได้ V = 0.5 เราไม่ได้ใช้ p = 0.6 เลย เมื่อกำหนดราคาวันนี้ ราคาสองกิ่ง และดอกเบี้ยไว้แล้ว การเปลี่ยนโอกาสขึ้นจาก 60% เป็น 70% จะเปลี่ยน payoff คาดหมาย แต่ไม่เปลี่ยนราคาเลียนแบบ ตราบใดที่ทั้งสองกิ่งยังเกิดได้และสมมติฐานการซื้อขายยังใช้ได้
เราสามารถเขียนคำตอบเดียวกันในรูปความน่าจะเป็นสำหรับกำหนดราคา เรียกว่า q โดยเลือกให้หุ้นคาดหมายเติบโตตามดอกเบี้ยปลอดความเสี่ยง: 100 = q × 101 + (1 − q) × 99 ได้ q = 0.5 แล้วราคา Call เป็น q × 1 + (1 − q) × 0 = 0.5 เหมือนคำตอบจาก Hedge ทุกประการ
เราไม่ได้เปลี่ยนคำพยากรณ์จาก 60% เป็น 50% และไม่ได้อ้างว่าผู้ลงทุนจริงไม่กลัวความเสี่ยง คนที่เป็น risk-averse อาจชอบเงิน 100.2 ที่ได้แน่นอน มากกว่าเงินสุ่ม 101/99 ที่มีค่าเฉลี่ย 100.2 เท่ากัน ส่วน risk-neutral pricing เป็นวิธีเขียนราคาให้สอดคล้องกับ no arbitrage ในตลาดที่สร้างพอร์ตเลียนแบบได้ จึงยังใช้ได้แม้ผู้ลงทุนจริงจะไม่ชอบความเสี่ยง
ไม่ต้องรู้ p แต่ยังต้องรู้ช่วงที่ราคาเคลื่อนไหว
ลองขยายราคาพรุ่งนี้เป็น 102 กับ 98 แทน 101 กับ 99 โดยคงราคาเริ่มต้นและ K ที่ 100 และดอกเบี้ย 0% ไว้ Call จะจ่าย 2 หรือ 0 และราคาเลียนแบบเพิ่มจาก 0.5 เป็น 1 ดอลลาร์ ดังนั้นการตัด p ออกจากการคำนวณราคา ไม่ได้แปลว่าความสุ่มหมดความสำคัญ ขนาดการแกว่งของราคายังเปลี่ยน payoff และราคา Option ได้ นี่เป็นทางเชื่อมไปสู่บทบาทของ volatility
ถ้าดอกเบี้ยไม่เป็นศูนย์ล่ะ
ให้ r_d เป็นดอกเบี้ยปลอดความเสี่ยง ตลอดหนึ่งวันที่เหลือ ในรูปทศนิยม ไม่ใช่อัตราต่อปี ภาระ −49.5 พรุ่งนี้ต้องคิดลดกลับมา จึงได้
ตัวอย่าง r_d = 0.0001 หรือ 0.01% ต่อวัน ให้ V ประมาณ 0.50495 และ q = 0.505 โดยต้องมี 99 < 100(1+r_d) < 101 เพื่อให้แบบจำลองไม่มี arbitrage และทั้งสองกิ่งมีน้ำหนัก q ระหว่าง 0 กับ 1
ผลเท่ากันทั้งสองกิ่งเกิดจากโลกจำลองที่มีเพียงสองผลลัพธ์และซื้อขายได้ตามสมมติฐาน เมื่อเพิ่มหลายช่วงเวลา hedge ratio อาจเปลี่ยน และในตลาดจริงการปรับพอร์ตมีต้นทุน ราคากระโดดได้ และแบบจำลองอาจผิด จึงไม่ควรตีความตัวอย่างนี้ว่ากลยุทธ์ Quant ทุกชนิดไร้ความเสี่ยง
สิ่งที่สินทรัพย์ทางการเงินมีเหมือนกัน
เมื่อเราลงทุนในหุ้น สินค้าโภคภัณฑ์ งานศิลปะ หรือแม้แต่ม้าแข่ง สิ่งที่สนใจคือผลตอบแทนจากเงินที่ลงไป ผลตอบแทนในความหมายนี้ประกอบด้วยการเพิ่มขึ้นของมูลค่าสินทรัพย์และกระแสเงินสดที่ได้รับระหว่างถือครอง เทียบกับมูลค่าตั้งต้น
ถ้าหุ้นสองตัวขึ้นเท่ากัน 10 ดอลลาร์ เราได้ผลตอบแทนเท่ากันไหม? ลองให้หุ้น A เริ่มที่ 100 ดอลลาร์ ส่วนหุ้น B เริ่มที่ 1,000 ดอลลาร์ แล้วสมมติว่าครบหนึ่งปีทั้งคู่ขึ้นมาอีก 10 ดอลลาร์ โดยไม่มีเงินปันผล
หุ้น A ขึ้นจาก 100 เป็น 110 ดอลลาร์ คิดเป็นผลตอบแทน 10% ส่วนหุ้น B ขึ้นจาก 1,000 เป็น 1,010 ดอลลาร์ คิดเป็นเพียง 1% ลองใช้เงินตั้งต้นเท่ากันที่ 1,000 ดอลลาร์ เราจะซื้อ A ได้สิบหุ้นและมีกำไร 100 ดอลลาร์ แต่ซื้อ B ได้หนึ่งหุ้นและมีกำไร 10 ดอลลาร์ ก่อนหักต้นทุนซื้อขาย จำนวนเงินที่ราคาขึ้นจึงต้องเทียบกับเงินที่เราใช้ลงทุนด้วย
เมื่อสร้างแบบจำลองเพื่อเปรียบเทียบสินทรัพย์ เราควรให้ความสำคัญกับ ผลตอบแทน มากกว่าระดับราคาเพียงอย่างเดียว หุ้น เงินตรา สินค้าโภคภัณฑ์ และดัชนีจึงใช้คำถามเริ่มต้นร่วมกันได้ว่า เราคาดหวังผลตอบแทนเท่าไร และผลตอบแทนนั้นไม่แน่นอนเพียงใด
ตัวอย่าง A และ B ตรึงการเพิ่มขึ้นไว้ที่ 10 ดอลลาร์เพื่อแยกเรื่องฐานเงินลงทุน จึงไม่ได้เปรียบเทียบความเสี่ยงของหุ้นจริงสองตัว
การศึกษาข้อมูลผลตอบแทน
ต้นฉบับใช้ข้อมูลราคาของ Perez Companc กลุ่มธุรกิจในอาร์เจนตินา ช่วงกุมภาพันธ์ 1995 ถึงพฤศจิกายน 1996 เป็นตัวอย่าง ภาพราคามีแนวโน้มเพิ่มขึ้นโดยรวม แต่ไม่ได้เพิ่มอย่างสม่ำเสมอ ผู้ลงทุนที่ซื้อและขายผิดจังหวะยังอาจขาดทุนมากได้
แบบจำลองต้องรองรับความไม่แน่นอนที่ปรากฏในกราฟ เราจึงเริ่มจากแบบจำลองที่มีฐานเป็นความน่าจะเป็น
เปลี่ยนอนุกรมราคาให้เป็นอนุกรมผลตอบแทน
ให้ Sᵢ แทนราคาในวันที่ i ผลตอบแทนจากวันที่ i ถึงวันที่ i + 1 คือ
ในขั้นนี้ละเงินปันผลไว้ก่อน หากต้องรวมกระแสเงินสดก็เพิ่มเข้าไปในตัวเศษ ข้อมูลไม่จำเป็นต้องเว้นช่วงวันละหนึ่งครั้งเสมอไป เราจะกลับมาพิจารณาผลของช่วงเวลาที่ใช้เก็บข้อมูลในหัวข้อ 3.6
เมื่อเปลี่ยนจากราคามาเป็นผลตอบแทน กราฟจะมีลักษณะขึ้นลงคล้ายสัญญาณรบกวนมากขึ้น นี่คือสิ่งที่เราจะนำมาจำลอง ไม่ใช่เพียงเส้นระดับราคาที่เห็นในตอนแรก
ค่าเฉลี่ยและส่วนเบี่ยงเบนมาตรฐานของกลุ่มตัวอย่าง
หากมีผลตอบแทน M ค่า ค่าเฉลี่ยของกลุ่มตัวอย่างคือ
ส่วนเบี่ยงเบนมาตรฐานของกลุ่มตัวอย่างคือ
จำนวนผลตอบแทนน้อยกว่าจำนวนราคาหนึ่งค่า เพราะแต่ละผลตอบแทนต้องใช้ราคาสองจุดต่อกัน ในตัวอย่างข้อมูลชุดที่หนังสือใช้ ผู้เขียนรายงานค่าเฉลี่ยผลตอบแทนรายวัน 0.002916 และส่วนเบี่ยงเบนมาตรฐาน 0.024521 หรือประมาณ 0.2916% และ 2.4521% ตามลำดับ
ส่วนเบี่ยงเบนมาตรฐานมีขนาดใหญ่กว่าค่าเฉลี่ยรายวันมาก ประเด็นนี้อธิบายว่าทำไมในช่วงสั้นเราจึงเห็นความแกว่งของราคาชัดกว่าแนวโน้มเฉลี่ย และอาจต้องสังเกตเป็นเวลานานขึ้นจึงจะเริ่มเห็นแนวโน้มได้
กราฟทดลองด้านบนใช้ราคา 34 จุดที่อ่านได้จากตารางรูป 3.3 หน้า 60 จึงได้ผลตอบแทน 33 ค่า ตัวเลข 0.002916 และ 0.024521 เป็นสถิติที่หนังสือรายงานสำหรับชุดข้อมูลที่ผู้เขียนใช้ ไม่ได้คำนวณจาก 34 แถวที่มองเห็นเท่านั้น อีกทั้งราคาที่พิมพ์ในตารางปัดไว้สองตำแหน่ง การคำนวณกลับจึงอาจไม่ตรงกับคอลัมน์ผลตอบแทนในหนังสือทุกหลัก
จากฮิสโตแกรมไปสู่การแจกแจง Normal
นอกจากดูการเปลี่ยนแปลงตามเวลา เราควรดูการกระจายความถี่ของผลตอบแทนด้วย ฮิสโตแกรมบอกว่าผลตอบแทนช่วงใดเกิดบ่อย ช่วงใดเกิดน้อย และการกระจายมีรูปร่างอย่างไร
ในรูป 3.5 ผู้เขียนนำการกระจายของผลตอบแทน Perez Companc มาปรับให้มีค่าเฉลี่ยศูนย์ ส่วนเบี่ยงเบนมาตรฐานหนึ่ง และพื้นที่รวมใต้การกระจายเท่ากับหนึ่ง แล้วเปรียบเทียบกับความหนาแน่นของ standard Normal:
เส้นของข้อมูลจริงกับเส้น Normal ไม่เหมือนกันทุกจุด แต่ผู้เขียนถือว่าใกล้พอที่จะใช้เป็นแบบจำลองอย่างง่ายในขั้นนี้ นอกจากนี้ต้นฉบับยังแสดงฮิสโตแกรมผลตอบแทน Glaxo–Wellcome จาก Bloomberg ในรูป 3.6 ซึ่งยังไม่ได้ปรับมาตรฐาน
หากเรายอมรับการประมาณด้วย Normal พร้อมสมมติว่าค่าเฉลี่ยและส่วนเบี่ยงเบนมาตรฐานเป็นค่าคงที่ที่ทราบ เราจะเขียนผลตอบแทนได้ว่า
สมการนี้ทำให้เราสร้างผลตอบแทนขึ้นมาได้จากเลขสุ่มมาตรฐานเพียงตัวเดียว การคูณด้วยส่วนเบี่ยงเบนมาตรฐานกำหนดความกว้างของการกระจาย ส่วนการบวกค่าเฉลี่ยเลื่อนศูนย์กลางไปยังตำแหน่งที่ต้องการ
การที่ฮิสโตแกรมดูคล้าย Normal เป็นเหตุผลให้ลองใช้แบบจำลอง แต่ยังไม่ใช่หลักฐานว่าหางการกระจายหรือพฤติกรรมตามเวลาของข้อมูลถูกอธิบายครบแล้ว โดยเฉพาะกราฟย่อยจาก 33 ผลตอบแทนในหน้านี้ ซึ่งมีไว้สาธิตขั้นตอน ไม่ใช่ทดสอบความเหมาะสมของ Normal แทนข้อมูลเต็มชุด
มาตราส่วนของเวลา
ค่าเฉลี่ยและส่วนเบี่ยงเบนมาตรฐานที่เพิ่งประมาณได้เป็นค่าของผลตอบแทนในช่วงเวลาที่เราใช้เก็บข้อมูล หากเปลี่ยนจากรายวันเป็นรายชั่วโมงหรือรายสัปดาห์ ค่าสองตัวนี้จะเปลี่ยนตามอย่างไร?
ให้ δt แทนความยาวของช่วงเวลา ค่าเฉลี่ยของผลตอบแทนช่วงสั้นแปรตามความยาวของช่วงเวลา เราจึงเขียน
μ เป็นค่าคงที่ในแบบจำลองขั้นนี้ ถ้าใช้ปีเป็นหน่วยเวลา และสมมติให้หนึ่งปีมี 252 วันซื้อขาย ช่วงหนึ่งวันจะเท่ากับ δt = 1/252 จากค่าเฉลี่ยรายวันของ Perez Companc ในหนังสือ:
ตัวเลขนี้คือ drift ที่ annualize จากค่าเฉลี่ยในช่วงตัวอย่าง ไม่ใช่ผลตอบแทนที่รับประกัน และไม่ใช่ CAGR ที่คำนวณจากราคาต้นงวดกับปลายงวด
เริ่มจากกรณีที่ยังไม่มีความสุ่ม
หากพักส่วนสุ่มไว้ก่อน แบบจำลองจะเป็น
เริ่มจาก S₀ เมื่อผ่านไปหนึ่ง step จะได้ S₀(1 + μδt) สอง step เป็น S₀(1 + μδt)² และเมื่อผ่านไป M step โดย T = Mδt:
ลูกศรหมายถึงลิมิตเมื่อ δt เล็กลงไปหาศูนย์ โดยตรึงระยะเวลารวม T ไว้ ผลลัพธ์จึงบอกสองเรื่อง ประการแรก เมื่อไม่มีความสุ่ม ราคาจะเติบโตแบบเอ็กซ์โพเนนเชียลคล้ายเงินฝากที่ทบต้นต่อเนื่อง ประการที่สอง วิธีปรับค่าเฉลี่ยตาม δt ทำให้แบบจำลองยังมีความหมายเมื่อ time step เล็กลง
ส่วนสุ่มต้องย่อตามรากที่สองของเวลา
สำหรับส่วนสุ่ม สิ่งที่รวมกันเมื่อช็อกแต่ละช่วงเป็นอิสระคือ ความแปรปรวน ไม่ใช่ส่วนเบี่ยงเบนมาตรฐาน หากมี T/δt step เราต้องให้ความแปรปรวนต่อ step มีขนาดแปรตาม δt เพื่อให้ความแปรปรวนรวมในช่วง T ไม่หายไปเป็นศูนย์หรือเพิ่มจนไม่จำกัดเมื่อย่อ time step
ดังนั้น ส่วนเบี่ยงเบนมาตรฐานต่อ step ต้องแปรตาม √δt:
σ เป็นพารามิเตอร์ที่กำหนดขนาดความสุ่ม ยิ่ง σ มาก ผลตอบแทนยิ่งกระจายกว้าง จากตัวเลขในหนังสือ:
นำมาตราส่วนทั้งสองกลับมาใส่ในแบบจำลองผลตอบแทน เราจะได้
หรือเขียนเป็นการเปลี่ยนแปลงของราคาโดยตรง:
ด้านซ้ายคือราคาที่เปลี่ยนไปหนึ่ง step ด้านขวาคือแบบจำลองที่แยกเป็นส่วนค่าเฉลี่ยและส่วนสุ่ม เรารู้ราคาวันนี้ แต่ราคาวันถัดไปกระจายอยู่รอบค่าที่แบบจำลองกำหนด แทนที่จะมีค่าปลายทางเพียงค่าเดียว
Drift
μ เรียกว่า drift rate, expected return หรือ growth rate ในบริบทของแบบจำลองนี้ ประมาณได้จาก
โดยทั่วไปเลือกปีเป็นหน่วยเวลา จึงรายงาน μ ในรูปอัตราต่อปี พารามิเตอร์นี้ประมาณได้ยากในทางสถิติ เพราะในช่วงสั้นส่วนค่าเฉลี่ยมีขนาดเล็กและถูกความสุ่มบดบังได้ง่าย
ต้นฉบับชี้ว่า drift ที่แท้จริงของสินทรัพย์มีบทบาทน้อยในทฤษฎีกำหนดราคาออปชันแบบคลาสสิก ความยากในการประมาณมันจึงไม่ได้เป็นอุปสรรคในลักษณะเดียวกับการพยากรณ์ผลตอบแทน อย่างไรก็ตาม ในการจัดพอร์ตและในทฤษฎีนอกกรอบคลาสสิก drift อาจสำคัญมาก
Volatility
σ เรียกว่า volatility หรือความผันผวน ประมาณได้จาก
เช่นเดียวกับ drift เรามักรายงานเป็นค่าที่ annualize แล้ว Volatility เป็นปริมาณสำคัญในทฤษฎีอนุพันธ์ แต่ก็เป็นปริมาณที่ประมาณและจำลองได้ยาก ผู้เขียนจึงกลับมาพิจารณาเรื่องนี้ซ้ำในหลายส่วนของหนังสือ
เนื่องจาก drift โตตามเวลา แต่ขนาดส่วนสุ่มโตตามรากที่สองของเวลา ผลของทั้งสองจึงต่างกันในแต่ละช่วง ในช่วงสั้น volatility มักเด่นกว่า ส่วนเมื่อมองช่วงยาว drift อาจเริ่มเห็นได้ชัดขึ้น า โดยเส้นค่าเฉลี่ยโตเป็นเส้นตรง และกรอบหนึ่งส่วนเบี่ยงเบนมาตรฐานกว้างขึ้นตาม √เวลา
ภายใต้ Normal ช่วงค่าเฉลี่ย ±1 SD ครอบคลุมความน่าจะเป็นประมาณ 68.3% ณ เวลาที่กำหนด ไม่ได้หมายความว่าเส้นทางทั้งเส้นจะอยู่ในกรอบตลอดช่วงด้วยโอกาส 68.3% และกฎ √เวลาอาศัยสมมติฐานเรื่องการพึ่งพากันและความแปรปรวนของ increments
การประมาณความผันผวน
วิธีที่ตรงไปตรงมาที่สุดคือคำนวณส่วนเบี่ยงเบนมาตรฐานของผลตอบแทน แล้วปรับตามช่วงเวลาที่ใช้เก็บข้อมูลดังสูตรข้างต้น หาก δt เล็กพอ ผลของค่าเฉลี่ยรายช่วงอาจเล็กจนละไว้ในการประมาณได้
เมื่อช่วงเวลาสั้น ผลตอบแทนยังประมาณได้ด้วยผลต่างของลอการิทึมราคา จึงมีรูปประมาณอีกแบบว่า
สูตรนี้เขียนตามการประมาณในต้นฉบับ ซึ่งละค่าเฉลี่ยของ log return ไว้ หากคำนวณส่วนเบี่ยงเบนมาตรฐานของกลุ่มตัวอย่างโดยตรง ควรหักค่าเฉลี่ยก่อนตามนิยาม
import numpy as np

log_returns = np.diff(np.log(prices))
annualized_vol = log_returns.std(ddof=1) * np.sqrt(252)
ddof=1 ทำให้ตัวหารของ sample variance เป็น M − 1 เพื่อให้ตรงกับนิยามส่วนเบี่ยงเบนมาตรฐานของกลุ่มตัวอย่าง หากใช้ตัวหาร M จะได้ค่าต่างกัน โดยเฉพาะเมื่อข้อมูลมีจำนวนน้อย
ความผันผวนวันนี้ต้องประมาณจากข้อมูลเมื่อวาน
ในทางปฏิบัติ volatility ไม่น่าจะคงที่ตลอดเวลา ภาวะเศรษฐกิจ ฤดูกาล และปัจจัยอื่น ๆ เปลี่ยนไป แต่หากต้องการประมาณความผันผวนวันนี้ เราต้องอาศัยข้อมูลที่เกิดขึ้นแล้ว จึงไม่มีหลักประกันว่าตัวเลขจากอดีตจะสะท้อนความผันผวนปัจจุบันได้พอดี
วิธีทั่วไปคือใช้ราคาปิดคำนวณผลตอบแทนรายวัน แล้วเลือกผลตอบแทนย้อนหลัง เช่น 10, 30 หรือ 100 ค่า มาหาความผันผวน ทุกค่าในหน้าต่างมีน้ำหนักเท่ากัน ผลตอบแทนที่รุนแรงหนึ่งวันจึงมีผลต่อค่าประมาณตลอดเวลาที่มันยังอยู่ในหน้าต่าง และผลนั้นจะหายไปทันทีเมื่อวันดังกล่าวหลุดออก
นี่คือ plateauing effect ที่ผู้เขียนชี้ให้เห็นในรูป 3.9 ค่าประมาณอาจค้างสูงอยู่ช่วงหนึ่งแล้วลดลง เพราะโครงสร้างของวิธีคำนวณ ไม่ใช่เพราะความผันผวนจริงของตลาดเปลี่ยนเป็นขั้นบันไดแบบนั้น
ด้วยเหตุที่ volatility สังเกตโดยตรงไม่ได้ และวิธีหน้าต่างเลื่อนมีข้อจำกัดนี้ เราจึงอาจต้องพิจารณาวิธีประมาณอื่น ๆ ซึ่งหนังสือกลับมาขยายความในบทที่ 49
Wiener process
ในหัวข้อมาตราส่วนของเวลา เราแยกการเปลี่ยนแปลงออกเป็น drift ที่แปรตาม δt กับส่วนสุ่มที่มีขนาดแปรตาม √δt แล้ว ถ้าอยากอธิบายการเปลี่ยนแปลงในเวลาต่อเนื่อง เราต้องพิจารณาว่าเกิดอะไรขึ้นเมื่อช่วงเวลา δt เล็กลงไปหาศูนย์
เราจะใช้สัญลักษณ์ d เพื่อแทนการเปลี่ยนแปลงในเวลาต่อเนื่อง เช่น dS สำหรับการเปลี่ยนแปลงของราคา เทอม drift ซึ่งมี δt เป็นตัวคูณเปลี่ยนไปเป็นเทอมที่มี dt ได้ค่อนข้างตรงไปตรงมา แต่เทอมสุ่มซึ่งมี √δt ต้องระวังกว่า
เราไม่อาจจัดการมันเหมือนอนุพันธ์ธรรมดาโดยเพียงแทน δt ด้วย dt แล้วมอง √dt เป็นตัวเลขเล็ก ๆ ตัวหนึ่ง เพราะส่วนสุ่มมีค่าเฉลี่ยศูนย์ แต่มีความแปรปรวนที่สะสมตามเวลา ความละเอียดอ่อนของสองคุณสมบัตินี้คือเหตุผลที่ต้องใช้กรอบ stochastic calculus
เขียนส่วนสุ่มในเวลาต่อเนื่องด้วย dX ซึ่งเป็น increment ของ Wiener process แนวคิดเบื้องต้นคือ increment นี้มีค่าเฉลี่ยศูนย์และความแปรปรวน dt:
Wiener process คือ process Xₜ ส่วน dX เป็นสัญลักษณ์ของ increment ในเวลาต่อเนื่อง หากเขียนสำหรับช่วงเวลาบวก Δt อย่างชัดเจน คุณสมบัติที่เกี่ยวข้องคือ
โดย standard Wiener process เริ่มที่ X₀ = 0 มี increments ในช่วงที่ไม่ทับกันเป็นอิสระ และมีเส้นทางต่อเนื่อง สัญลักษณ์ Wₜ ที่อาจพบในตำราอื่นใช้แทน process ชนิดเดียวกัน
ในภาพทดลอง เมื่อเราเพิ่มจำนวน step increments แต่ละ step มีขนาดเล็กลง แต่ความแปรปรวนของผลรวมในหนึ่งปียังคงเป็นหนึ่ง ผลนี้เกิดจากการปรับขนาดด้วยรากที่สองของเวลา การเพิ่มความละเอียดจึงไม่ได้ทำให้ความสุ่มทั้งหมดหายไป
รายละเอียดของการอินทิเกรตและการคำนวณกับ Wiener process จะเป็นเนื้อหาของบทที่ 4 สำหรับตอนนี้ เป้าหมายคือเห็นว่าเรามีภาษาที่ใช้เชื่อมแบบจำลองสุ่มแบบไม่ต่อเนื่องเข้ากับเวลาต่อเนื่องแล้ว
แบบจำลองสำหรับหุ้น เงินตรา สินค้าโภคภัณฑ์ และดัชนี
นำสัญลักษณ์ Wiener process กลับมาใส่ในแบบจำลองราคา จะได้
นี่คือ stochastic differential equation สมการแรกที่สร้างขึ้นในบท มันบรรยายการเปลี่ยนแปลงของราคาด้วยสองส่วน: การเปลี่ยนแปลงเฉลี่ย μS dt และส่วนสุ่ม σS dX ทั้งสองส่วนแปรตามระดับราคาปัจจุบัน S
แบบจำลองนี้เป็นฐานสำคัญของทฤษฎีการเงินหลายเรื่อง และเมื่อ μ, σ คงที่ เราเรียกแบบจำลองราคานี้ว่า geometric Brownian motion หรือ GBM เราได้สมการนี้จากการพิจารณาผลตอบแทน รูปร่างการกระจาย และการปรับขนาดตามเวลาในหัวข้อก่อนหน้า
การเปลี่ยนแปลงเฉลี่ย มีขนาดแปรตาม dt
ค่าเฉลี่ยของ increment เป็นศูนย์ ขนาดความผันผวนแปรตาม √dt
Monte Carlo: ถ้าอนาคตเกิดซ้ำได้หลายพันครั้ง
สมการบอกกติกาการเคลื่อนไหวของราคา แต่เส้นทางหนึ่งเส้นยังบอกภาพรวมได้ไม่มาก Monte Carlo คือการใช้กติกาเดียวกันสุ่มหลายเส้นทาง แล้วรวบรวมผล เช่น ราคาปลายปีเฉลี่ย หรือสัดส่วนเส้นทางที่จบต่ำกว่าราคาเริ่มต้น
ลองเริ่มจากหุ้นราคา 100 ดอลลาร์ กำหนด μ และ σ แล้วกดสุ่ม เราไม่ได้ทายว่าเส้นไหนจะเกิดขึ้นจริง แต่กำลังดูว่า ถ้าแบบจำลองและสมมติฐานนี้ใช้ได้ ผลลัพธ์จะกระจายอย่างไร กดสุ่มใหม่จะเห็นคำตอบเปลี่ยนเล็กน้อย แม้ใช้สมมติฐานเดิม
การเพิ่มจำนวนรอบช่วยให้เราประมาณผลของแบบจำลองได้แม่นขึ้น แต่ไม่ได้รับประกันว่าแบบจำลองจะอธิบายตลาดจริงได้ดีขึ้น ความผิดพลาดจากการสุ่มคำนวณกับความผิดพลาดของแบบจำลองเป็นคนละเรื่องกัน
Key takeaways — สิ่งที่อยากให้เก็บกลับไป
เวลาวิเคราะห์การลงทุน เราควรเริ่มที่ผลตอบแทน เพราะมันบอกการเปลี่ยนแปลงเทียบกับเงินที่ลงทุน และช่วยให้เปรียบเทียบสินทรัพย์ที่มีระดับราคาต่างกันได้
ในทฤษฎีการเงิน เรามักมองผลตอบแทนเป็นตัวแปรสุ่ม เราไม่รู้แน่นอนว่าครั้งต่อไปจะได้เท่าไร แต่สามารถศึกษาและสร้างแบบจำลองของความน่าจะเป็นได้
การแจกแจงแบบ Normal เป็นสมมติฐานตั้งต้นที่มีประโยชน์ แม้ไม่สมบูรณ์ เรามักใช้ประมาณผลตอบแทนในช่วงเวลาสั้น ๆ แต่ผลตอบแทนจริงอาจมีหางหนาหรือไม่สมมาตร จึงต้องตรวจว่าสมมติฐานเหมาะกับข้อมูลแค่ไหน
เราจึงสร้างแบบจำลองราคาเป็น lognormal random walk ได้ ในแบบจำลอง GBM ที่ μ และ σ คงที่ log-return มีการแจกแจงแบบ Normal ส่วนราคาที่เวลาใดเวลาหนึ่งในอนาคตมีการแจกแจงแบบ Lognormal และเป็นบวก ทั้งนี้ การสมมติให้ผลตอบแทนธรรมดาเป็น Normal เพียงอย่างเดียวไม่ได้ทำให้ราคาเป็น Lognormal โดยอัตโนมัติ
GBM เป็นแบบจำลองราคาสินทรัพย์พื้นฐานที่ใช้กันแพร่หลาย และเขียนเป็นสมการเชิงอนุพันธ์สุ่มได้ คือ dS = μS dt + σS dX ซึ่งรวมส่วนแนวโน้มเฉลี่ยกับส่วนสุ่มไว้ด้วยกัน และเป็นจุดเริ่มต้นของการเรียน stochastic calculus ต่อไป
ภาคทดลองเพิ่มเติม
ลองตรวจความเข้าใจด้วยคำถามสั้น ๆ แล้วปรับพารามิเตอร์เพื่อดูเส้นราคาหลายเส้นที่เป็นไปได้ภายใต้แบบจำลองเดียวกัน
ทดลองต่อ: หลายเส้นทางของ GBM และคำตอบแบบ exact
เมื่อ μ และ σ คงที่ และราคาเริ่มต้นเป็นบวก สูตรคำตอบของ GBM คือ
สูตรนี้คงราคาเป็นบวก และใช้จำลองค่าที่จุดเวลาได้ตรงตามการแจกแจงของแบบจำลอง โดยไม่ต้องใช้การประมาณราคาด้วยการบวก drift และช็อกทีละ step เทอม −σ²/2 อธิบายด้วย Itô’s lemma ในเนื้อหาที่ต่อจากบทนี้
ในพื้นที่ทดลองนี้ใช้ S₀ = 100, μ = 15%, σ = 25% และระยะเวลา 1 ปี ค่าเฉลี่ยตามทฤษฎีประมาณ 116.18 ส่วนมัธยฐานประมาณ 112.61 ความต่างระหว่างสองค่านี้เกิดจากรูปร่างการกระจายที่เบ้ไปทางขวา ไม่ใช่ข้อผิดพลาดในการจำลอง
อ้างอิง
Louis Bachelier (1900), Théorie de la spéculation: แนวคิดเปิดบทเรื่องความน่าจะเป็นและราคา
Paul Wilmott (2006), Paul Wilmott on Quantitative Finance, 2nd ed., บท 3 หน้า 55–70: เนื้อหาที่นำมาแปลและเรียบเรียง สมการ ตัวอย่างราคาหุ้น 50/150 ที่ปรับความน่าจะเป็นเพื่อเปรียบเทียบ p กับ q และหุ้น A/B; ข้อมูล Perez Companc เป็นข้อมูลประวัติศาสตร์ตามหนังสือ
Options Industry Council, Options Basics: สิทธิซื้อ/ขาย ราคาใช้สิทธิ วันหมดอายุ และ premium
Clare Wallace, Durham University, The one-period binomial model: แนวคิดพอร์ตเลียนแบบและการกำหนดราคาแบบทวินาม