Stochastic Processes — Definitions and Examples
ผลตอบแทนสองชุดมีการแจกแจงเหมือนกัน แต่พยากรณ์ได้ต่างกันได้อย่างไร?
“เราต้องการคำอธิบายที่สอดคล้องกับหลักฐานเชิงประจักษ์…”
“We seek statements that are empirically credible…”
— Stephen J. Taylor · Asset Price Dynamics, Volatility, and Prediction, น. 1 · ข้อความบางส่วน แปลไทยเพื่อประกอบบทเรียน
จากข้อมูลหนึ่งชุดไปสู่กระบวนการสุ่ม
ใน Prices and Returns เราเริ่มจากราคาที่เกิดขึ้นแล้ว เมื่อต้องการพยากรณ์ เราต้องระบุว่าอนาคตเกิดค่าใดได้บ้าง และแต่ละค่ามีโอกาสมากน้อยเพียงใด กระบวนการสุ่ม หรือ stochastic process คือชุดตัวแปรสุ่มที่มีดัชนีเวลา
การแจกแจงของ วันเดียวบอกโอกาสของค่าที่อาจเกิดขึ้น ส่วนการแจกแจงร่วมของหลายวันบอกว่าค่าเหล่านั้นสัมพันธ์กันอย่างไร Histogram ที่เหมือนกันจึงยังให้แบบจำลองคนละแบบได้ หากลำดับเวลาต่างกัน
บทนี้ครอบคลุมหัวข้อ 3.1–3.11 ในสารบัญของ Taylor ใช้แบบจำลองที่กำหนดพารามิเตอร์เพื่อคำนวณตามได้ ก่อนนำไปอ่านพฤติกรรมผลตอบแทนจริงใน Stylized Facts
ตัวแปรสุ่มและการแจกแจง
ตัวแปรสุ่ม X แปลงผลลัพธ์ของการสุ่มเป็นตัวเลข ส่วน x คือค่าที่สังเกตได้ครั้งหนึ่ง ฟังก์ชันการแจกแจงสะสม ใช้ได้ทั้งกรณีต่อเนื่องและไม่ต่อเนื่อง ถ้ามี density จะได้
Density เป็นความหนาแน่น ไม่ใช่ความน่าจะเป็น ณ จุดนั้น สำหรับการแจกแจงต่อเนื่อง ความน่าจะเป็นของจุดเดียวเป็นศูนย์ แม้ density ตรงจุดนั้นจะสูง
เมื่อโมเมนต์มีค่าจำกัด เรานิยาม
Correlation คือ covariance หารด้วย เมื่อ SD ทั้งสองเป็นบวก จึงไม่มีหน่วยและอยู่ระหว่าง −1 กับ 1 มันวัดความสัมพันธ์เชิงเส้น การที่ correlation เป็นศูนย์ยังอาจมีความสัมพันธ์รูปอื่นอยู่
ตัวอย่างให้ X เป็น −1, 0, 1 ด้วยโอกาสเท่ากัน และกำหนด Y=X² จะได้ E[X]=0, E[Y]=2/3 และ E[XY]=E[X³]=0 จึงมี covariance เป็นศูนย์ แต่เมื่อรู้ X เรารู้ Y ทันที ตัวอย่างนี้จึงไม่เป็นอิสระ
ข้อมูลที่รู้ก่อนเวลา t เขียนเป็น ค่าเฉลี่ยแบบมีเงื่อนไข เปลี่ยนได้เมื่อได้รับข้อมูลใหม่ แม้ค่าเฉลี่ยที่มองรวมทุกสภาวะจะคงเดิม กฎ total variance แยกสองส่วนนี้ได้ว่า
สูตรนี้แยกความผันผวนที่ยังเหลือเมื่อรู้ข้อมูลแล้ว ออกจากความต่างของค่าเฉลี่ยระหว่างสภาวะ
Stationarity ต้องคงที่ในความหมายใด
Strict stationarity หมายถึงการแจกแจงร่วมของทุกชุดเวลาคงเดิมเมื่อเลื่อนเวลาทั้งชุดเท่ากัน สำหรับจำนวนจุด k และระยะเลื่อน h ใด ๆ
Weak หรือ covariance stationarity ใช้เพียงโมเมนต์อันดับหนึ่งและสองที่มีค่าจำกัด
Covariance ขึ้นกับระยะห่าง k แต่ไม่ขึ้นกับวันเริ่ม t และเมื่อ จะมี ACF ทฤษฎี
Strict stationarity ที่มี second moment จำกัดให้ weak stationarity ด้วย แต่ weak stationarity โดยทั่วไปยังไม่รับรองการแจกแจงร่วมทั้งหมด สำหรับกระบวนการ jointly Gaussian ค่าเฉลี่ยและ covariance กำหนดการแจกแจงร่วม จึงเชื่อมสองนิยามนี้ได้ ส่วน iid Cauchy เป็น strict stationary แต่ไม่มี variance จำกัด
ตัวอย่าง random walk เริ่มจาก X₀=0 และช็อก iid mean 0, variance σ² จะมี Var(Xₜ)=tσ² จึงไม่เป็น weak stationary ขณะที่ผลต่าง เป็น stationary
Stationarity กล่าวถึงการแจกแจง ไม่ได้กำหนดให้กราฟต้องเรียบ และไม่ได้รับรองว่าค่าเฉลี่ยจากเส้นทางเดียวจะเข้าใกล้ค่าเฉลี่ยประชากรเสมอไป การใช้ข้อมูลเส้นทางเดียวแทนประชากรยังต้องพิจารณา ergodicity และเงื่อนไขการพึ่งพากันด้วย
AR, MA และ ARMA
ให้ B เป็น backshift operator: BXₜ=Xₜ₋₁ เขียน ARMA(p,q) ที่มีค่าเฉลี่ย μ ได้เป็น
AR ใช้ค่าก่อนหน้าของ X ส่วน MA ใช้ช็อกปัจจุบันและอดีต คำว่า moving average ใน MA จึงหมายถึงการรวมช็อก ไม่ใช่เส้นค่าเฉลี่ยเคลื่อนที่ของราคาที่ใช้บนกราฟเทคนิค บทนี้ใช้เครื่องหมายบวกหน้าพารามิเตอร์ MA บางโปรแกรมใช้เครื่องหมายลบ ต้องตรวจ convention ก่อนเทียบ θ
สำหรับ causal stationary solution ของ ARMA ที่ไม่มีตัวประกอบร่วม รากของ φ(z)=0 ต้องอยู่นอก unit circle ส่วน invertibility ต้องการรากของ θ(z)=0 อยู่นอก unit circle เพื่อให้กู้ innovations จากข้อมูลปัจจุบันและอดีตได้อย่างเสถียร เงื่อนไขสองข้อนี้ตรวจคนละ polynomial
AR(1) เขียนเป็น เมื่อ |φ|<1 และ Var(ε)=σ² จะได้
φ เป็นบวกให้ ACF ลดลงโดยมีเครื่องหมายบวก ถ้า φ เป็นลบ เครื่องหมายสลับกัน MA(1) เขียนเป็น และมี
ดูที่มาของโมเมนต์ AR(1) และ MA(1) ใน Penn State STAT 510, Lesson 1 และ Lesson 2 การอ่าน sample ACF ใช้ความคลาดเคลื่อนของตัวอย่างร่วมด้วย เส้นที่ประมาณจากข้อมูลจะไม่ตัดเป็นศูนย์พอดีตามทฤษฎี
ลองคำนวณ ARMA(1,1)
กำหนดค่าเฉลี่ยศูนย์ และ
แทน Xₜ₋₁ ย้อนกลับไปเรื่อย ๆ จะได้ค่าสัมประสิทธิ์ของช็อก และ เมื่อ j≥1 จากผลรวมอนุกรมเรขาคณิต
| φ | θ | Var(X) เมื่อ σ²=1 | ρ₁ | ลักษณะ |
|---|---|---|---|---|
| 0.6 | 0.3 | 2.265625 | 0.732414 | ACF เป็นบวกและค่อยลดลง |
| −0.6 | 0.3 | 1.140625 | −0.336986 | ACF สลับเครื่องหมาย |
| 0.6 | −0.6 | 1 | 0 | AR กับ MA หักล้างกัน |
กรณี θ=−φ มีตัวประกอบร่วม หักล้างกัน จึงเหลือ Xₜ=εₜ สำหรับ stationary solution การใส่พารามิเตอร์สองตัวไม่ได้รับรองว่าแบบจำลองมีความสัมพันธ์ข้ามเวลาสองส่วนที่แยกประมาณได้
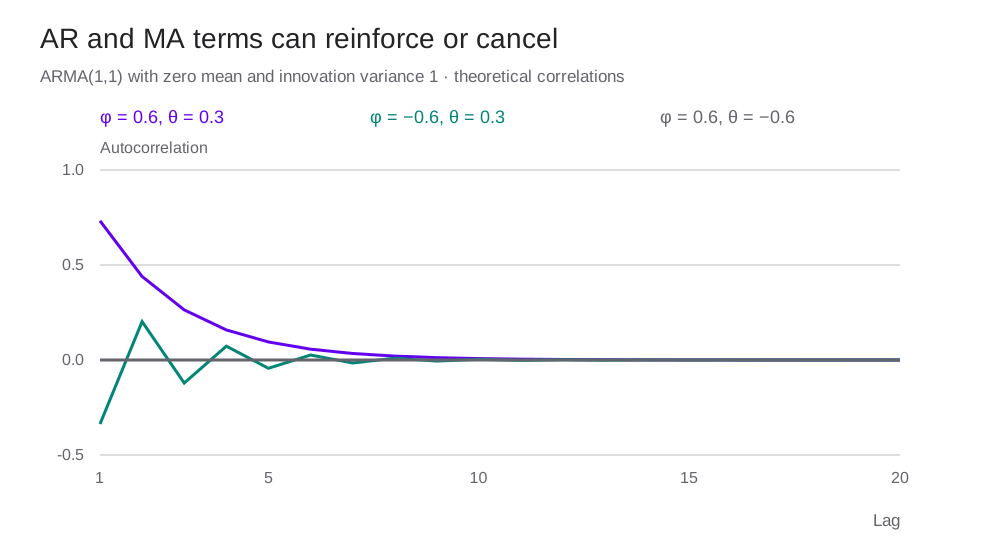
ตัวทดลองใช้ช็อก Normal ชุดเดิมเมื่อปรับ φ และ θ จำลองช่วงเริ่มต้น 1,000 ค่าก่อนเก็บ 600 ค่าเพื่อลดผลของค่าเริ่มต้น กราฟ sample ACF ใช้ข้อมูลจำลอง ส่วนเส้นทฤษฎีคำนวณจากสูตรโดยตรง ทั้งสองเส้นจึงไม่จำเป็นต้องทับกัน
ARIMA และการหาผลต่าง
ARIMA(p,d,q) ให้ผลต่างอันดับ d ของข้อมูลเป็น ARMA(p,q) โดย d เป็นจำนวนเต็มไม่ติดลบ
เมื่อ d=1 ตัวแปรที่ใช้คือ ΔXₜ=Xₜ−Xₜ₋₁ หาก Xₜ เป็น log price ผลต่างนี้คือ log return ตัวอย่าง random walk with drift: เป็น ARIMA(0,1,0) และมีผลต่าง mean c
d=2 ใช้ อย่าหาผลต่างเพิ่มเพียงเพื่อให้กราฟดูเรียบ หาก Xₜ เป็น white noise อยู่แล้ว ΔXₜ จะเป็น MA(1) ที่ θ=−1 และมี ρ₁=−1/2 เราจึงอาจสร้างความสัมพันธ์ขึ้นจากการแปลงที่ไม่จำเป็น
การหาผลต่างเพื่อจัดการ unit root ต่างจากการหักเส้นแนวโน้ม deterministic ต้องเลือกให้ตรงกับสมมติฐานของข้อมูล ดู Hyndman และ Athanasopoulos, Stationarity and differencing
ARFIMA และความสัมพันธ์ที่ลดลงช้า
ARFIMA(p,d,q) ขยาย d ให้เป็นเศษส่วน ใช้
ค่าสัมประสิทธิ์คำนวณต่อกันได้จาก และ เช่น d=0.3 ให้สี่พจน์แรก 1, −0.3, −0.105, −0.0595 จึงใช้ข้อมูลอดีตหลายช่วงแทนการลบเพียงช่วงเดียว
เมื่อเงื่อนไขของ AR และ MA ผ่าน ช่วง −0.5<d<0.5 ให้กระบวนการ stationary และ invertible ตามเงื่อนไขมาตรฐาน สำหรับ 0<d<0.5 เกิด long memory โดย ACF ลดลงในอัตรากำลัง ซึ่งช้ากว่าการลดแบบเรขาคณิตของ ARMA ส่วน d<0 ให้พฤติกรรม antipersistence
ใน ARFIMA(0,d,0) ที่ 0<d<0.5 มีสูตร
ที่ d=0.3 จะได้ ρ₁=0.428571 และ ρ₂≈0.327731 แม้ lag แรกไม่ได้ใกล้ 1 ความสัมพันธ์ก็ยังอยู่ได้หลาย lag ดูแนวคิดและตัวอย่างประมาณ d ใน Penn State STAT 510, Lesson 13
ในการคำนวณต้องตัดอนุกรมอนันต์เป็นจำนวนพจน์จำกัดและบอกว่าตัดที่ไหน การเห็น sample ACF ลดลงช้าเพียงอย่างเดียวยังแยก long memory ออกจาก structural breaks ไม่ได้ ควรตรวจช่วงข้อมูลและเทียบแบบจำลองอื่นด้วย
Linear stochastic processes
กระบวนการเชิงเส้นที่มีค่าเฉลี่ยศูนย์เขียนเป็นผลรวมของช็อกได้ว่า
ถ้า ε เป็น white noise variance σ² เงื่อนไขผลรวมกำลังสองทำให้อนุกรมลู่เข้าใน mean square และมี
ที่มาเห็นได้จากการคูณ Xₜ กับ Xₜ₋ₖ แล้วหาค่าคาดหมาย พจน์ที่เป็นช็อกคนละเวลามี covariance ศูนย์ เหลือเฉพาะคู่ที่ใช้ ε ตัวเดียวกัน สูตร ARMA(1,1) ด้านบนจึงตรวจได้อีกทางด้วยการแทน ψ ลงในผลรวมนี้
เงื่อนไข เข้มกว่าผลรวมกำลังสอง และมักใช้กับ short-memory filters ส่วน long-memory processes บางแบบมีผลรวมกำลังสองจำกัด แม้ผลรวมค่าสัมบูรณ์ไม่จำกัด
คำว่า linear กล่าวถึงการรวมช็อก กระบวนการเชิงเส้นอาจมีช็อกที่ไม่เป็น Normal ได้ ขณะเดียวกันการแปลง X เป็น X² จะเปลี่ยนความสัมพันธ์ข้ามเวลา ดูสูตรใน ภาคผนวก squared linear process
กระบวนการในเวลาต่อเนื่อง
Wiener process Wₜ เริ่มที่ศูนย์ มีเส้นทางต่อเนื่อง และ independent increments โดย ตัว Wₜ มี variance t จึงไม่ stationary แต่ increments ในช่วงความยาวเท่ากันมีการแจกแจงเดียวกัน
แบบจำลองราคา GBM คือ
เมื่อ μ และ σ คงที่ log returns ในช่วงที่ไม่ทับกันและยาวเท่ากันเป็น iid Normal ราคามีการแจกแจง Lognormal การนำโมเดลนี้ไปใช้กับข้อมูลที่มี volatility clustering จึงต้องตรวจสมมติฐานเพิ่มเติม
อีกตัวอย่างคือ Ornstein–Uhlenbeck: เมื่อ κ>0 และเริ่มจากการแจกแจง stationary จะมี mean m, variance และ correlation ที่ห่าง h เท่ากับ หากเก็บทุก Δ หน่วยเวลา จะได้ AR(1) ที่ φ=exp(−κΔ) โมเดลนี้จึงเชื่อมเวลาต่อเนื่องกับเวลาที่เราเก็บข้อมูลได้
เวลาในสมการต้องใช้หน่วยเดียวกับพารามิเตอร์ เช่น μ ต่อปี, σ ต่อรากปี และ h เป็นปี ดู derivation ของ GBM และ Itô's lemma ใน Applied Stochastic Calculus
สัญลักษณ์ของแบบจำลองและข้อมูล
| สัญลักษณ์ | ความหมาย |
|---|---|
| Xₜ | ตัวแปรสุ่ม ณ เวลา t |
| xₜ | ค่าที่สังเกตได้จากตัวแปรนั้น |
| μ, γₖ, ρₖ | ค่าเฉลี่ย covariance และ correlation ของประชากร |
| x̄, γ̂ₖ, ρ̂ₖ | ค่าที่ประมาณจากตัวอย่าง |
| εₜ | innovation หรือช็อก โดยต้องระบุสมมติฐาน |
| ℱₜ | ข้อมูลที่รู้ได้ถึงเวลา t |
| B | ตัวดำเนินการเลื่อนกลับหนึ่งช่วง |
| h, Δ | ระยะเวลา ต้องระบุหน่วย |
ตัวอักษร R และ r ในบทผลตอบแทนใช้แยก simple กับ log return แทนการแยกตัวแปรสุ่มกับค่าที่สังเกต จึงควรอ่านนิยามของแต่ละบทควบคู่ไปด้วย ในหน้านี้ใช้ Xₜ กับ xₜ เพื่อแยกสองความหมายอย่างชัดเจน
ทดลองและตรวจคำตอบ
- Random walk เริ่มที่ศูนย์และมี innovation variance 4 จะมี variance ที่ t=10 เท่าไร? ผลต่างหนึ่งช่วงมี variance เท่าไร?
- ARMA(1,1) ที่ φ=0.6, θ=0.3 และ σ²=1 มี variance และ ρ₂ เท่าไร?
- เปลี่ยน θ เป็น −0.6 แล้วอธิบายว่าทำไม sample ACF ยังไม่เป็นศูนย์ทุกจุด แม้ ACF ทฤษฎีเป็นศูนย์
- คำนวณ π₁, π₂ และ π₃ ของ fractional difference เมื่อ d=0.3
เปิดแนวคำตอบ
ข้อ 1 variance ของระดับเท่ากับ 10×4=40 ส่วนผลต่างเท่ากับ 4
ข้อ 2 variance 2.265625, ρ₁≈0.732414 และ ρ₂≈0.439448
ข้อ 3 ตัวประกอบ AR และ MA หักล้างกันใน stationary solution แต่ sample ACF มี sampling error จากข้อมูลจำนวนจำกัด
ข้อ 4 ได้ −0.3, −0.105 และ −0.0595 ตามลำดับ
ดาวน์โหลด Notebook เพื่อคำนวณโมเมนต์ ARMA, coefficient ของ linear process, fractional differences และตัวอย่าง uncorrelated แต่ dependent
แหล่งอ้างอิง
- Stephen J. Taylor, Asset Price Dynamics, Volatility, and Prediction (2005), ขอบเขตหัวข้อบท 3 · สารบัญ คำนำ และบทนำ
- Penn State, STAT 510: AR(1) และ stationarity, MA และ convention, fractional differencing
- Aditya Guntuboyina, UC Berkeley, Statistics 153 Lecture Eight: causal ARMA และ linear representations
- Hyndman และ Athanasopoulos, Forecasting: Principles and Practice, Stationarity and differencing
- ตารางเทียบหัวข้อบท 2–4
สมการและตัวอย่างในหน้านี้เรียบเรียงและคำนวณใหม่ตามหัวข้อที่ระบุ ไม่ได้อ้างว่าเป็นคำแปลเต็มบทหรือผลประมาณพารามิเตอร์จากตลาด