Optimization Problem
จะเลือกคำตอบที่ดีที่สุดอย่างไร เมื่อมีข้อบังคับว่าคำตอบนั้นต้องทำอะไรได้บ้าง?
“คำตอบโดยประมาณของคำถามที่ถูกต้อง แม้คำถามนั้นมักคลุมเครือ ก็ยังดีกว่าคำตอบที่แม่นยำของคำถามที่ผิด …”
“Far better an approximate answer to the right question, which is often vague, than an exact answer to the wrong question …”
— John W. Tukey · The Future of Data Analysis (1962), น. 13–14
การหาเส้น regression กับการจัดพอร์ตดูเป็นคนละงาน แต่เขียนเป็นโจทย์ optimization ได้ทั้งคู่ งานแรกเลือกความชันและจุดตัดแกนให้ผลรวมความคลาดเคลื่อนยกกำลังสองต่ำที่สุด งานที่สองอาจเลือกน้ำหนักสินทรัพย์ให้ variance ต่ำที่สุด โดยต้องได้ผลตอบแทนคาดหวัง 10% และใช้งบลงทุนครบ 100%
ก่อนคำนวณ เราจึงต้องระบุว่าจะเลือกค่าอะไร วัดคำตอบด้วยเกณฑ์ไหน และมีข้อจำกัดใดบ้าง สามส่วนนี้คือ decision variables, objective function และ constraints การเพิ่มข้อห้ามขายชอร์ตเพียงข้อเดียวอาจทำให้น้ำหนักพอร์ตเปลี่ยน หรือทำให้เป้าหมายผลตอบแทนบางระดับไม่มีคำตอบ
บทนี้เริ่มจากภาพของโจทย์สองตัวแปร แล้วใช้ regression ฝึกอ่าน gradient และ Hessian ก่อนนำ Lagrange และ KKT ไปแก้ตัวอย่างสินทรัพย์สมมติสี่ตัว ผู้อ่านที่ต้องการทบทวนความหมายของ expected return และ covariance สามารถย้อนดูบท Portfolio Theory ได้
เขียนโจทย์ให้ครบก่อนกด Solve
โจทย์ optimization ทั่วไปเขียนได้ว่า
องค์ประกอบมีสามส่วน
- คือ objective function ที่ต้องการให้ต่ำสุดหรือสูงสุด เช่น variance ของพอร์ต
- คือเวกเตอร์ decision variables เช่น น้ำหนักสินทรัพย์แต่ละตัว
- และ คือ constraints เช่น น้ำหนักรวม 100%, ห้ามน้ำหนักติดลบ หรือ tracking error ไม่เกินเพดาน
การเปลี่ยนโจทย์ เป็น ไม่เปลี่ยนจุดที่เหมาะสม และการคูณ objective ด้วยค่าบวกพร้อมบวกค่าคงที่ก็ไม่เปลี่ยน แต่ค่าของ objective หลังแปลงต้องแปลงกลับก่อนตีความ
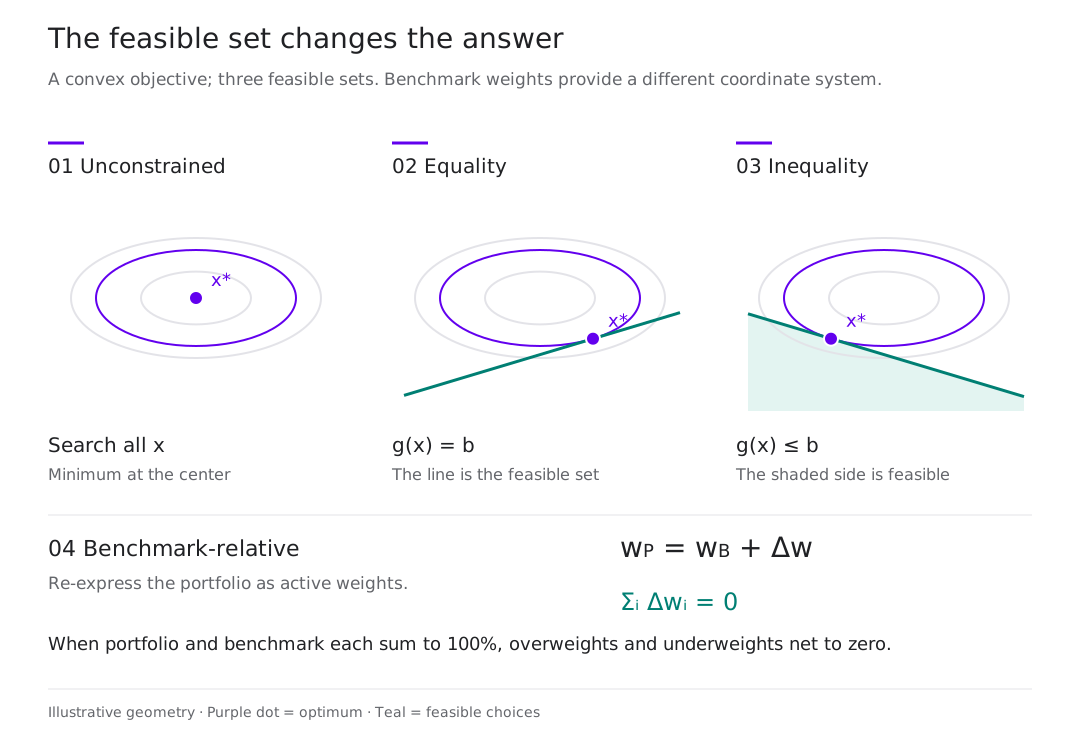
Objective เดิมไม่ได้รับประกันคำตอบเดิม เมื่อ feasible set เปลี่ยน จุดที่ดีที่สุดอาจย้ายจากก้นแอ่งไปอยู่บนเส้นหรือขอบเขตที่อนุญาต
ข้อจำกัดต้องใช้หน่วยเดียวกับข้อมูล ตัวอย่างเช่น ต่อปีต้องจับคู่กับ covariance ต่อปี และ target return 10% ต้องเขียนเป็น 0.10 หากสูตรใช้หน่วยทศนิยม การป้อน 10 ลงในสูตรเดียวกันจะเปลี่ยนโจทย์ไปหนึ่งร้อยเท่า
เห็น minimum ผ่าน gradient และ Hessian
เริ่มจากโจทย์ที่ยังไม่มี constraints ถ้า เรียบและจุดเหมาะสมอยู่ภายในโดเมน gradient ที่จุดนั้นต้องเป็นศูนย์
เงื่อนไขนี้คัดจุดที่เป็นไปได้ แต่ยังแยก minimum, maximum และ saddle point ไม่ได้ Hessian รวบรวมอนุพันธ์อันดับสองของ
ถ้า Hessian เป็น positive definite ที่ stationary point ฟังก์ชันโค้งขึ้นทุกทิศทางและจุดนั้นเป็น strict local minimum ถ้าเป็น negative definite จะได้ strict local maximum ส่วน Hessian ที่มีทั้งทิศบวกและลบชี้ไปที่ saddle point
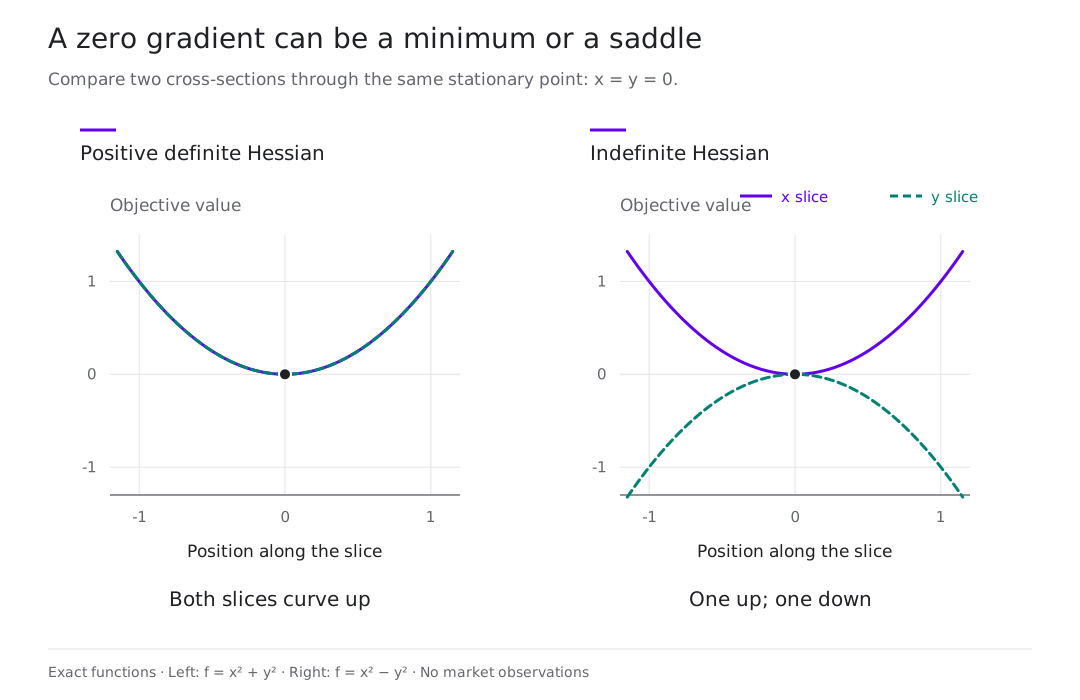
ทั้งสองกรณีมี gradient เป็นศูนย์ที่จุดกึ่งกลาง แต่เส้นตัดผ่านจุดนั้นแสดงว่าฝั่ง minimum โค้งขึ้นทั้งสองทิศทาง ส่วน saddle โค้งขึ้นทิศหนึ่งและโค้งลงอีกทิศหนึ่ง
Mean–variance แบบไม่มี constraint บนน้ำหนักสินทรัพย์เสี่ยง
ให้ เป็นผลตอบแทนสินทรัพย์ปลอดความเสี่ยง เป็นเวกเตอร์ผลตอบแทนคาดหวังของสินทรัพย์เสี่ยง และ เป็น covariance matrix น้ำหนักที่ไม่ได้ลงในสินทรัพย์เสี่ยงจะอยู่ในสินทรัพย์ปลอดความเสี่ยง โจทย์จึงเขียนเป็น
First-order condition ให้
เมื่อ กลับด้านได้
Hessian ของ objective คือ ถ้า positive definite ฟังก์ชันจะ concave อย่างเคร่งครัดและคำตอบนี้เป็น global maximum เพียงจุดเดียว ค่า เพิ่มสองเท่าจะลดน้ำหนักสินทรัพย์เสี่ยงทุกตัวลงครึ่งหนึ่งในโจทย์นี้ โดยน้ำหนักส่วนที่เหลือย้ายไปสินทรัพย์ปลอดความเสี่ยง
สูตรนี้ยังไม่ได้บังคับ long-only เพดานน้ำหนัก เงินกู้ หลักประกัน หรือต้นทุนซื้อขาย หากผลลัพธ์มีน้ำหนักรวม 160% จะหมายถึงกู้ 60% ที่อัตรา ภายใต้สมมติฐานของแบบจำลอง
Regression ก็เริ่มจาก objective
การประมาณ beta หรือ factor exposure เป็นโจทย์ optimization อีกแบบ ให้ เป็นผลตอบแทนสินทรัพย์ เป็นเมทริกซ์ปัจจัย และ เป็นสัมประสิทธิ์
Ordinary Least Squares เลือก เพื่อลดผลรวม residual ยกกำลังสอง
First-order condition ให้ normal equations
ถ้า มีคอลัมน์เป็นอิสระเชิงเส้นครบ
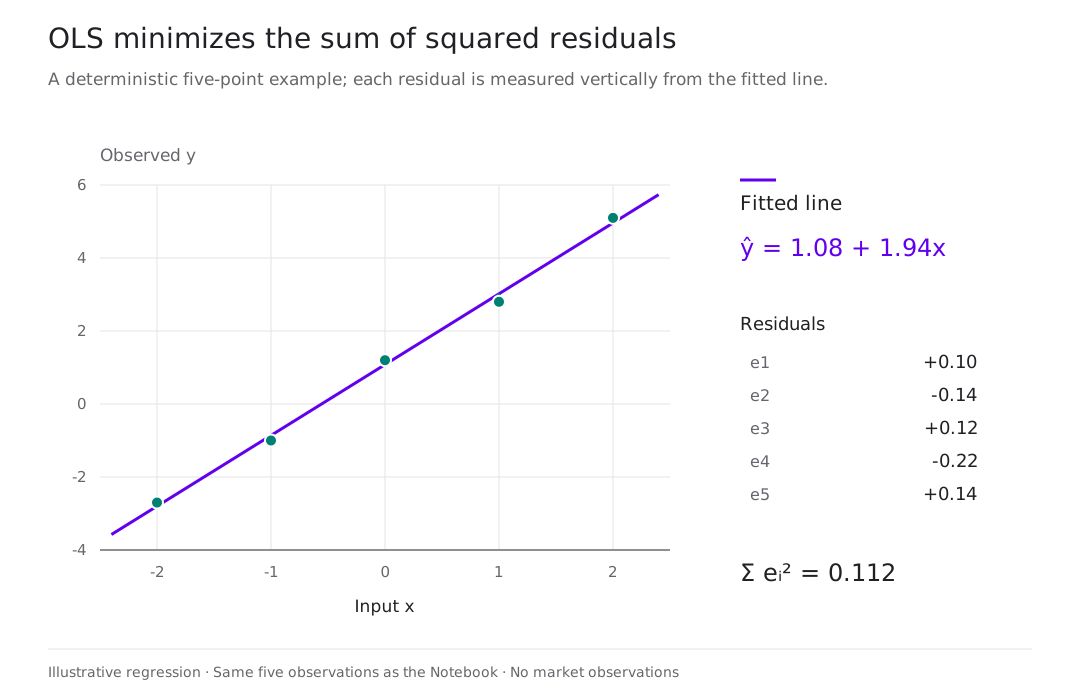
Residual บวกและลบหักล้างกันได้เมื่อรวมตรง ๆ OLS จึงรวมกำลังสองของระยะแต่ละจุด เส้นนี้เป็นตัวอย่างเชิงสอน ไม่ใช่ regression จากหลักทรัพย์จริง
Regression ที่ได้ beta จากข้อมูลย้อนหลังยังไม่พิสูจน์ CAPM ค่า beta และ alpha เปลี่ยนตามช่วงข้อมูล ความถี่ ตัวแทนตลาด และตัวแปรที่ใส่ใน
GLS เมื่อ residual มี covariance ไม่เท่ากับ
ให้
โดย positive definite Generalized Least Squares ใช้ระยะ Mahalanobis
จึงได้
ถ้า จาก Cholesky decomposition ให้ , และ จะได้
จากนั้นใช้ OLS กับ ได้คำตอบ GLS การแปลงนี้หมุนและปรับสเกล residual ให้ covariance เป็นเอกลักษณ์
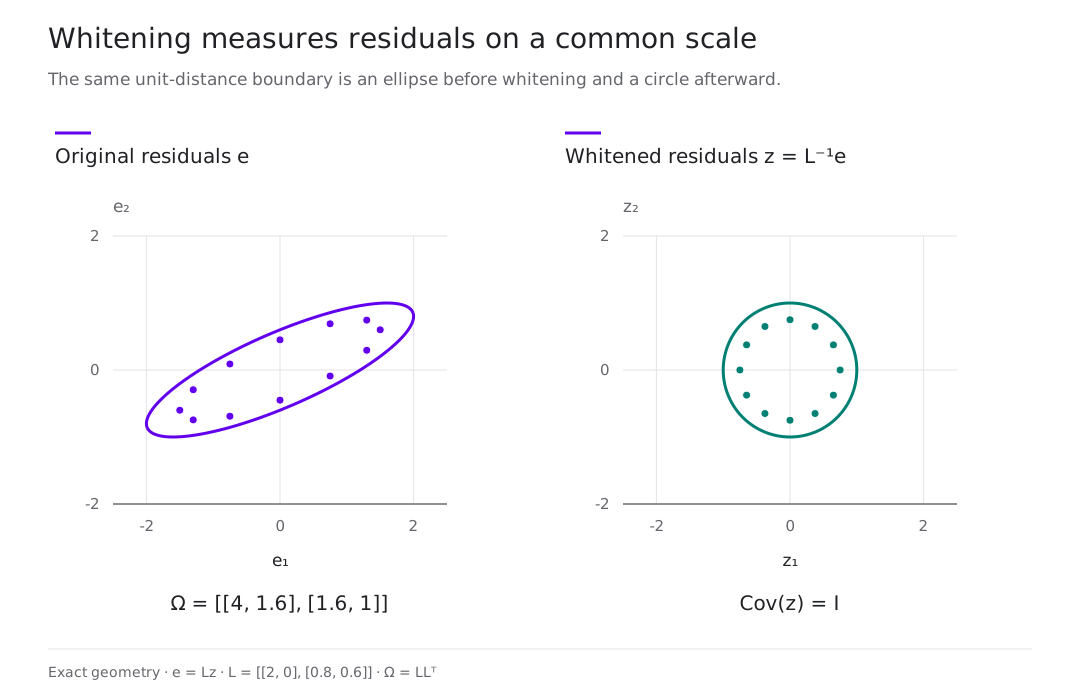
วงรีแสดง residual ที่มี scale และ correlation ต่างกัน หลัง whitening ระยะ Euclidean ในพิกัดใหม่เท่ากับ Mahalanobis distance ในพิกัดเดิม
ในงานจริง มักต้องประมาณ จึงได้ Feasible GLS ความแม่นของผลลัพธ์ขึ้นกับแบบจำลอง covariance ที่เลือกด้วย
Lagrange ใส่ equality constraints เข้าไปในสมการ

สมมติโจทย์มีข้อจำกัด เราสร้าง Lagrangian
แล้วแก้ระบบ
ที่จุดสัมผัส gradient ของ objective ขนานกับ gradient ของ constraint ให้ เป็นค่า objective ที่เหมาะสม ภายใต้เงื่อนไข regularity และ Lagrangian แบบที่เขียนข้างบน เรามี เครื่องหมายจะเปลี่ยนหากตั้ง Lagrangian คนละแบบ
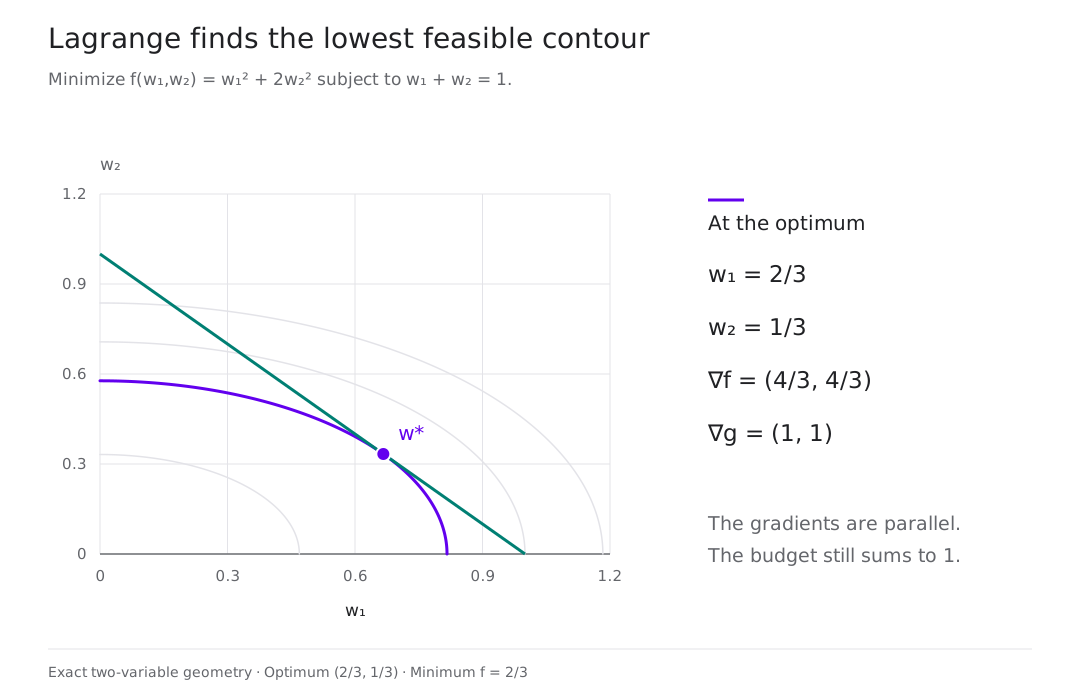
จุดที่ต่ำกว่านี้อยู่นอกเส้น constraint ส่วนจุดอื่นบนเส้นเดียวกันตัด contour ระดับสูงกว่า จุดสัมผัสจึงแก้ทั้ง stationarity และ constraint พร้อมกัน
ลองเลื่อนเส้นข้อจำกัด
ใช้ f(x,y) = (x − 1)² + 2(y − 1)² ซึ่งมีจุดต่ำสุดที่ (1,1) เลือกระหว่างไม่มีข้อจำกัด, x + y = c และ x + y ≤ c แล้วเลื่อนค่า c เพื่อดูว่าจุดต่ำสุดที่เลือกได้ย้ายไปอย่างไร เส้นวงรีแต่ละเส้นแสดงระดับของ objective เดียวกัน
ที่ c = 1 คำตอบบนขอบคือ (1/3, 2/3) ทั้งกรณี equality และ inequality แต่เมื่อ c = 3 ข้อจำกัด inequality เปิดทางให้เลือก (1,1) ได้แล้ว ส่วน equality ยังบังคับให้คำตอบอยู่บนเส้น x + y = 3 เราจะกลับมาอ่านเงื่อนไขนี้เป็น complementary slackness ในหัวข้อ KKT
สร้าง covariance matrix จาก volatility และ correlation
ตัวอย่างหลักใช้สินทรัพย์สมมติ และผลตอบแทน simple return ระยะหนึ่งปี
| สินทรัพย์ | ||||
|---|---|---|---|---|
| ผลตอบแทนคาดหวัง | 5% | 7% | 15% | 27% |
| ส่วนเบี่ยงเบนมาตรฐาน | 7% | 12% | 30% | 60% |
Correlation matrix คือ
สร้างเมทริกซ์แนวทแยง แล้วคำนวณ
เพราะ เป็นเมทริกซ์แนวทแยง เราจึงมี ค่าแนวทแยงของ คือ variance และค่านอกแนวทแยงคือ covariance
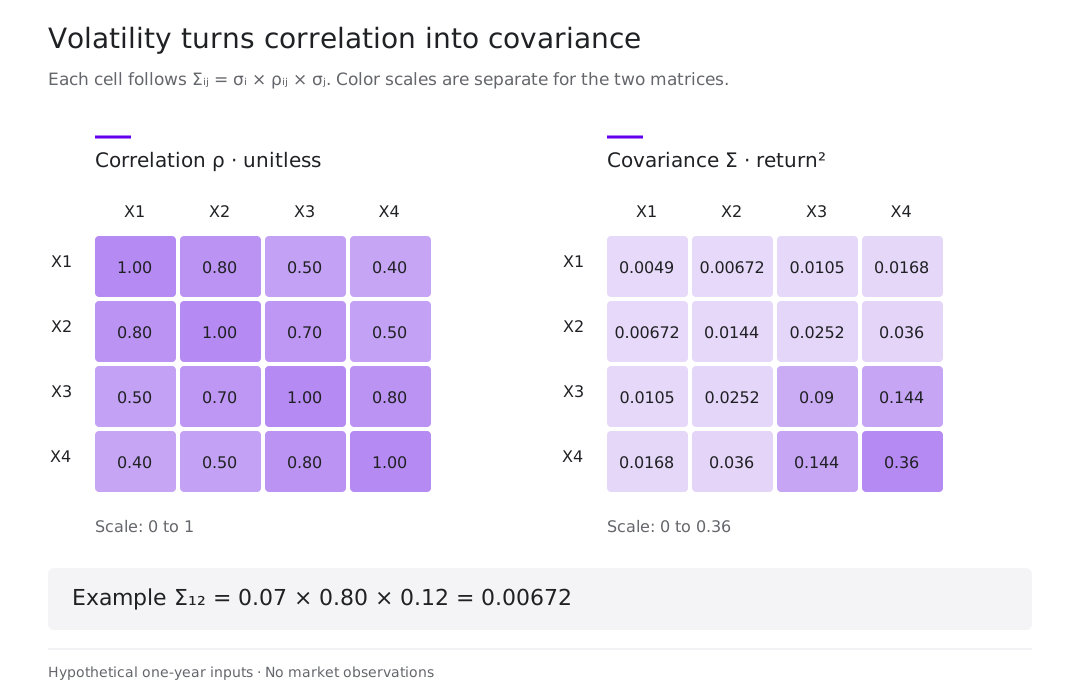
สีเข้มช่วยเปรียบเทียบขนาดภายในแต่ละเมทริกซ์ ส่วนตัวเลขเป็นค่าที่ใช้คำนวณจริง Correlation ไม่มีหน่วย ขณะที่ covariance ใช้หน่วยผลตอบแทนยกกำลังสอง
Covariance matrix ต้องเป็น positive semidefinite เพราะ คือ variance และห้ามติดลบ หากเมทริกซ์เกือบ singular การกลับเมทริกซ์โดยตรงจะขยายความคลาดเคลื่อน ควรแก้ระบบสมการและตรวจ condition number แทน
ลด variance โดยกำหนดผลตอบแทนเป้าหมาย
ให้ เป็นผลตอบแทนคาดหวังเป้าหมาย และอนุญาตให้ขายชอร์ตได้ โจทย์ risky-only คือ
subject to
ตั้ง
First-order condition ให้
ดังนั้น
กำหนดสเกลาร์
เมื่อ
ตัวอย่างสี่สินทรัพย์ให้
เมื่อ จะได้ , และ
น้ำหนักรวม 100% ผลตอบแทนคาดหวัง 10% และ volatility ประมาณ 16.1328%
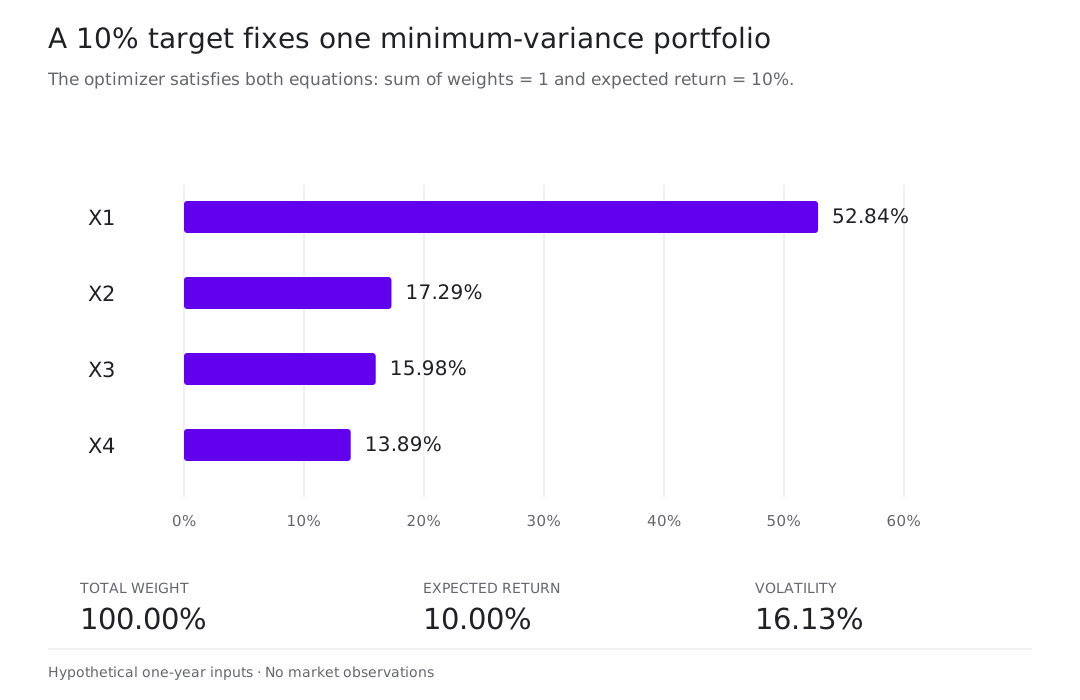
คำตอบนี้เป็นบวกทุกตัวโดยบังเอิญ ขอบเขตของโจทย์ยังอนุญาตให้ short และคำตอบเปลี่ยนทันทีเมื่อ target หรือ inputs เปลี่ยน
ในโค้ดควรแก้ระบบสมการเชิงเส้นหรือ KKT system แทนการสร้าง เต็มก้อน แล้วตรวจผลย้อนกลับว่า และ ภายใน tolerance ที่กำหนด
จาก target หนึ่งค่าไปสู่ทั้ง frontier
เมื่อปล่อยให้ เปลี่ยนไป variance ต่ำสุดของแต่ละ target คือ
Global minimum-variance portfolio อยู่ที่
สำหรับตัวอย่างนี้
ผลตอบแทนคาดหวังประมาณ 4.0187% และ volatility 6.4638% น้ำหนัก 127.49% มาจากการ short และ โจทย์คณิตศาสตร์ยอมรับคำตอบนี้เพราะเรายังไม่ได้ห้าม short หรือกำหนด gross exposure
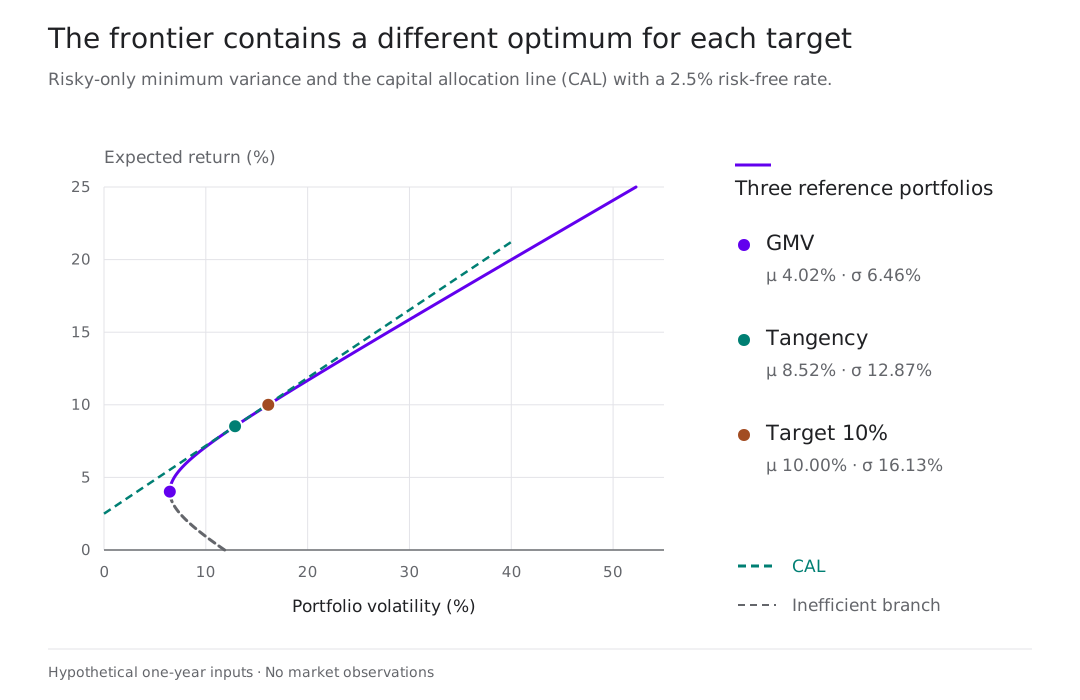
ครึ่งบนเหนือ GMV เป็น efficient branch ภายใต้ชุดสินทรัพย์และการอนุญาต short นี้ จุด target 10% เป็นคำตอบของ equality-constrained problem หนึ่งค่า
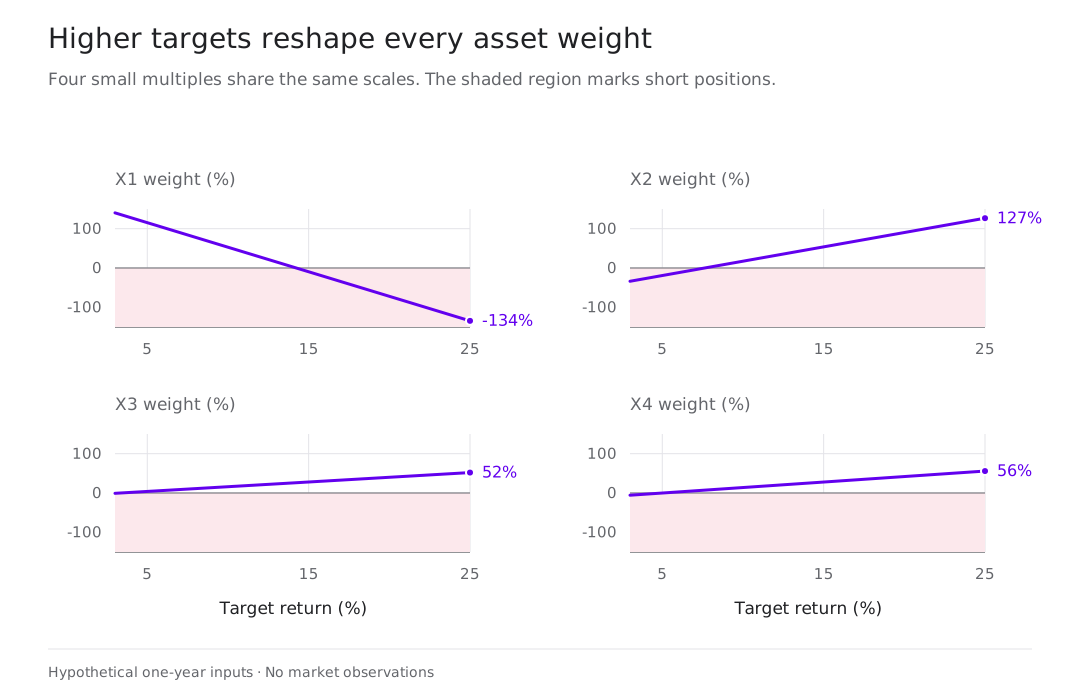
เมื่อ Target สูงขึ้น Optimizer ปรับ long–short หลายขาเพื่อให้ budget และ target เท่ากันพร้อมลด variance จึงต้องอ่านการเปลี่ยนแปลงของน้ำหนักทุกขาร่วมกัน
เพิ่มสินทรัพย์ปลอดความเสี่ยง
เมื่อ และต้องการผลตอบแทน น้ำหนักสินทรัพย์เสี่ยงที่ลด variance คือ
ที่
น้ำหนักสินทรัพย์เสี่ยงรวม 124.5108% น้ำหนักสินทรัพย์ปลอดความเสี่ยงจึงเป็น ซึ่งแปลว่ากู้เงินภายใต้สมมติฐานที่กู้ได้ที่ 2.5% โดยไม่มีข้อจำกัด
Tangency portfolio ของสินทรัพย์เสี่ยง normalize จากทิศทางเดียวกัน
พอร์ตนี้มีผลตอบแทนคาดหวังประมาณ 8.5236%, volatility 12.8731% และ Sharpe ratio ประมาณ 0.4679 ดูความหมายของ frontier, CAL และ tangency เพิ่มเติมได้ใน บท Portfolio Theory
KKT บอกว่า constraint ใดกำลังบังคับคำตอบ
ข้อจำกัด long-only เขียนเป็น เพดานน้ำหนักเขียนเป็น และข้อจำกัด gross exposure มักต้องเพิ่มตัวแปรช่วยเพื่อจัดการค่าสัมบูรณ์
สำหรับโจทย์
Karush–Kuhn–Tucker conditions ประกอบด้วย
Complementary slackness บอกว่า constraint ที่ยังเหลือช่องว่างต้องมี multiplier เป็นศูนย์ ส่วน multiplier บวกเกิดได้เมื่อ constraint ชนขอบ ใน convex quadratic portfolio problem ที่ constraints เป็น affine และมีจุด feasible ตามเงื่อนไข regularity KKT ใช้ยืนยัน global optimum ได้
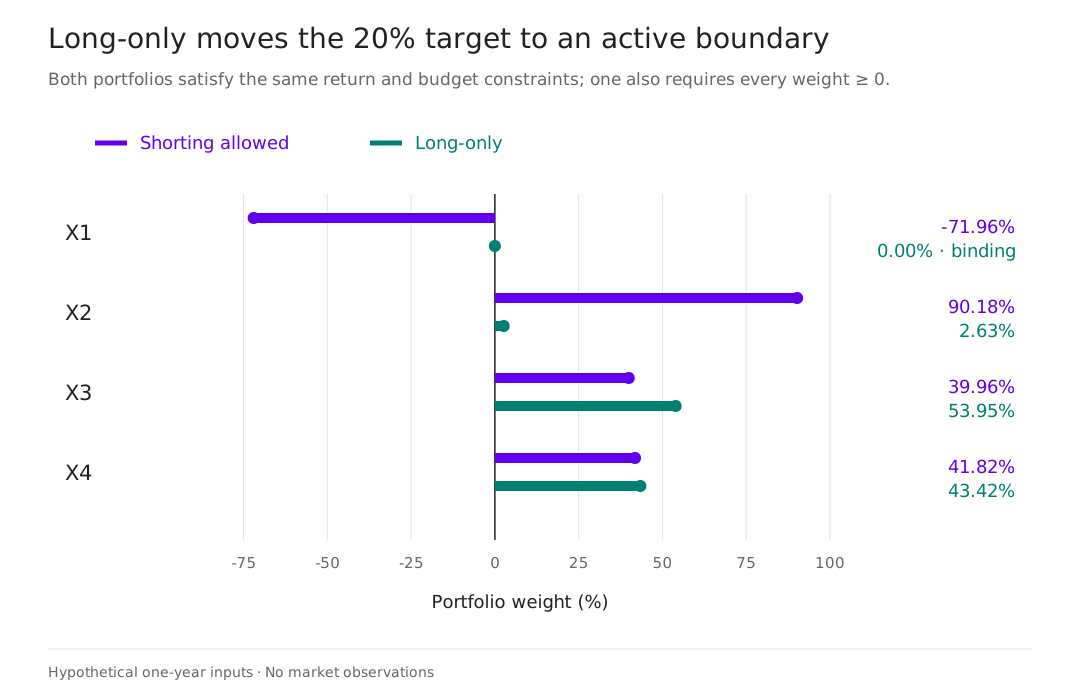
ในตัวอย่าง target 20% คำตอบ unconstrained มี ส่วน long-only ทำให้ constraint binding และเลือก
พอร์ต long-only สำหรับ target 20% คือ
มี volatility ประมาณ 40.3829% สูงกว่าคำตอบที่อนุญาต short เล็กน้อย ข้อจำกัดทำให้พอร์ตลงทุนได้ตามกติกา แลกกับ objective ที่แย่ลงหรือเท่าเดิม
130–30 บอก net และ gross exposure
พอร์ต 130–30 ถือสถานะ long รวม 130% และ short รวม 30%
Net exposure เท่ากับ 100% และ gross exposure เท่ากับ 160% ชื่อนี้ยังไม่กำหนดเองว่าควร long หรือ short ตัวใด ต้องมี objective, ข้อจำกัดรายสินทรัพย์ ต้นทุนยืม และกติกา rebalance เพิ่มเติม
แยก benchmark ออกจาก active positions
ให้ เป็นน้ำหนัก benchmark และ เป็นน้ำหนักพอร์ต กำหนด active weights
ถ้าพอร์ตและ benchmark ลงทุนครบ 100% ทั้งคู่
ผลตอบแทนพอร์ตแยกเป็น
Tracking error ภายใต้ covariance คือ
ตัวอย่าง active mean–variance problem ใช้
subject to และข้อจำกัดน้ำหนักหรือ tracking error ที่กองทุนใช้จริง
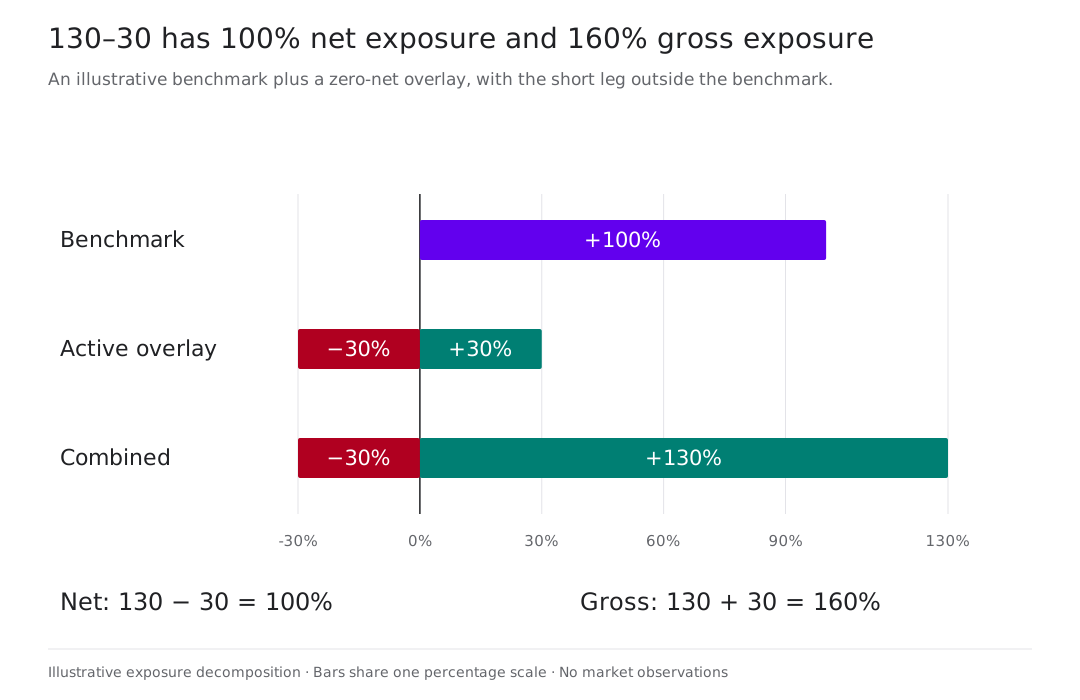
Active weight บวกคือ overweight เทียบ benchmark และค่าลบคือ underweight ค่าลบจะเป็น short ก็ต่อเมื่อน้ำหนักพอร์ตสุดท้าย ต่ำกว่าศูนย์ ผลรวม active weights เป็นศูนย์เพราะ benchmark รับ budget 100% ไว้แล้ว
Target เดียวกัน เมื่อห้ามขายชอร์ต
ใช้ค่าเฉลี่ยและ covariance ของสินทรัพย์สี่ตัวข้างต้น เปรียบเทียบพอร์ต variance ต่ำสุดที่ target เดียวกัน แล้วสังเกตว่าสินทรัพย์ใดมีน้ำหนักลดลงถึงศูนย์
ค่าเฉลี่ยของสินทรัพย์อยู่ระหว่าง 5% กับ 27% พอร์ตที่น้ำหนักไม่ติดลบและรวมเป็นหนึ่งจึงให้ผลตอบแทนคาดหวังนอกช่วงนี้ไม่ได้ หากเปิดขายชอร์ต ข้อจำกัดนี้หายไป แต่ขนาดสถานะและความเสี่ยงอาจเพิ่มขึ้นมาก
ตรวจ optimizer ก่อนเชื่อน้ำหนัก
| จุดที่ต้องตรวจ | วิธีตรวจ |
|---|---|
| หน่วยของ | ใช้ช่วงเวลาและรูปแบบทศนิยมเดียวกันทุกตัว |
| Constraint residuals | คำนวณ , และ inequality violations หลัง solve |
| Covariance เกือบ singular | ตรวจ eigenvalues/condition number ใช้ linear solve, regularization หรือ factor model ที่มีเหตุผลรองรับ |
| น้ำหนักไวต่อ expected returns | ขยับ และ ทีละน้อย แล้วเทียบ turnover, gross exposure และ objective |
| Solver status | แยก optimal, infeasible, unbounded และ numerical failure ไม่ใช้คำตอบล่าสุดเงียบ ๆ |
| In-sample fit | ทดสอบนอกช่วงที่ใช้ประมาณค่าและคิดต้นทุนซื้อขาย |
| Benchmark | ตรวจว่า active weights รวมเป็นศูนย์และใช้ benchmark ตัวเดียวกับรายงานผล |
การตรวจ residual ยืนยันว่าโปรแกรมแก้โจทย์ตามที่ตั้งไว้ได้ ส่วนผลตอบแทนหลังลงทุนยังขึ้นกับความคลาดเคลื่อนของ , และต้นทุนที่แบบจำลองอาจไม่ได้รวมไว้ จึงต้องทดสอบพอร์ตกับข้อมูลที่ไม่ได้ใช้ประมาณค่าและสถานการณ์ที่ต่างจากช่วงฝึกด้วย
ลองคำนวณต่อ
- ตรวจว่าน้ำหนัก target 10% รวมเป็นหนึ่ง และใช้ คำนวณผลตอบแทนกลับ
- ใช้ ใน แล้วสังเกตว่าการเปลี่ยนเครื่องหมาย ทำให้ constraints ผิดอย่างไร
- น้ำหนักสินทรัพย์เสี่ยงสำหรับ target 10% เมื่อมี รวมเป็นเท่าไร และต้องถือสินทรัพย์ปลอดความเสี่ยงเท่าไร
- ที่ target 20% long-only solution มี constraint ใด binding และ complementary slackness บอกอะไรเกี่ยวกับ multiplier ของ constraint นั้น
- ถ้า benchmark และพอร์ตลงทุนครบ 100% ทั้งคู่ จงพิสูจน์ว่า active weights รวมเป็นศูนย์
ดูแนวคำตอบ
- น้ำหนักรวมประมาณ 1 และ expected return ประมาณ 0.10 ส่วน volatility ประมาณ 0.161328
- เมื่อเปลี่ยนเป็น คำตอบจะไม่ใช่น้ำหนักชุดที่รายงานและไม่รักษา target/budget ตามระบบสมการเดิม
- Risky weights รวมประมาณ 1.245108 จึงมี risk-free weight ประมาณ −0.245108 หรือกู้ 24.5108%
- Constraint binding ที่ และ multiplier สามารถเป็นบวกได้ ส่วน constraint ที่ยัง slack ต้องมี multiplier ศูนย์
ทำต่อใน Python
ดาวน์โหลด Notebook ของบท Optimization Problem เพื่อสร้าง covariance, แก้ target-return portfolio, ตรวจ GMV และ tangency, ทำ GLS whitening และเปรียบเทียบ unconstrained กับ long-only solution ตัวอย่างทั้งหมดใช้ Python standard library และรันซ้ำได้
อ่านต่อ: Black–Litterman Portfolio
เมื่อกำหนด objective และ constraints ได้แล้ว ขั้นต่อไปคือเลือก expected returns ที่จะส่งเข้า optimizer บท Black–Litterman Portfolio ใช้สินทรัพย์สมมติและ covariance ชุดเดียวกัน เพื่อหา prior จากพอร์ตตลาดและผสมมุมมองของผู้ลงทุนพร้อมความไม่แน่นอน
ลองปรับความไม่แน่นอนของ views และ risk aversion ได้ใน ห้องทดลอง Black–Litterman
เอกสารประกอบ
- Fundamentals of Optimization and Application to Portfolio Selection, CQF, เนื้อหาเรื่อง objective, regression, Lagrange, KKT และ active portfolio